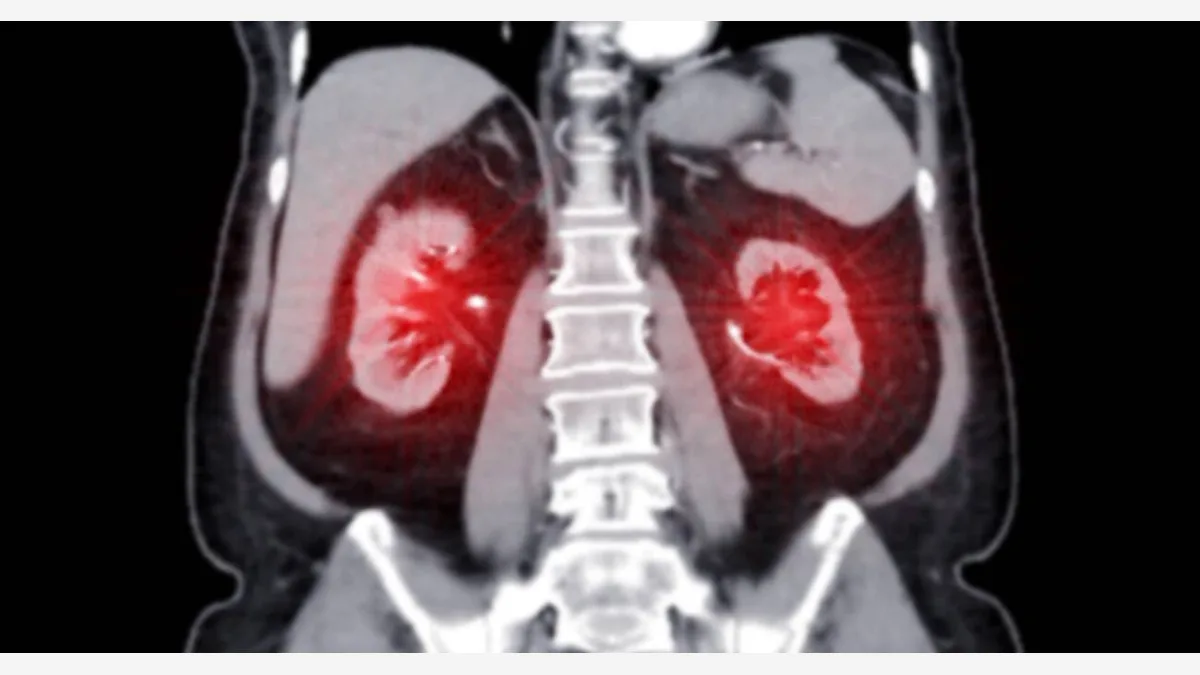
アリババの研究部門が、造影腹部CTを読影して146種類の臨床所見を報告する視覚言語モデル「RADAR」を、重みと研究論文ごと公開した。論文は9月17日付のScienceに掲載され、モデルはこれらの所見全体で曲線下面積(AUC)平均0.913に達した。
注目すべきは精度の数字そのものより、モデルの成り立ちだ。手描きのアノテーションなしで学習した汎用読影モデルを、現役の放射線科医と比較検証したうえで、無償で配布した。
要点
- RADARは造影腹部CT検査42万4911件と、解剖学単位の画像・テキスト対およそ1500万組で学習した。手作業のラベルではなく臨床レポートから学んでいる。
- 146所見の平均AUCは0.913。外部8施設での検証でも0.895を保ち、個別に学習していない救急症例2万7000件超でも0.904を記録した。
- 同じ評価で競合する視覚言語モデルの最高値はAUC 0.776にとどまった。RADARと併用した放射線科医は病変検出感度が約10%向上した。
ラベルなしで146所見を学習させる仕組み
従来の医用画像モデルは設計段階から守備範囲が狭い。膵臓病変を見つけるもの、肝臓の異常を指摘するものがそれぞれ別に学習され、その都度、放射線科医が対象の輪郭を描く必要がある。このアノテーションのボトルネックこそ、単一疾患向けのツールばかりが積み上がり、汎用モデルがほとんど生まれてこなかった理由だ。
DAMOアカデミーは逆の道を選んだ。浙江大学医学部附属第一病院、湖畔実験室と共同で開発したRADARは、CTボリュームを放射線科医がすでに書いた臨床レポートと対応づけ、レポートの文章そのものを教師情報として扱う。学習データが独立したラベリング事業ではなく日常診療の副産物になるわけで、研究チームが42万4911件の検査を集められたのもここに理由がある。
モデルは腹部18臓器を対象とし、そこから悪性腫瘍から偶発的に見つかる異常まで数百種類の疾患をカバーする。研究チームはRADARを医用画像分野で初の専門医レベルの汎用モデルと位置づけ、同じ学習手法は他の画像検査にも移せるとしている。
数字が耐えた検証
内部評価の精度は一つだけなら盛りやすい。だから見出しの数字より検証の設計が問われる。外部8施設での平均AUCは0.895までしか下がらなかった。症例構成が異なり専用の学習も経ていない救急部門の2万7000件超でも0.904を維持している。比較対象で最も強かったマルチモーダルモデルは0.776だった。
より実務に近い成果は読影者比較試験のほうだ。複数の病院から集まった放射線科医26人のうち、23人を平均で上回った。同じ医師がRADARを併用して読影すると、疾患検出感度は約10%上がり、読影時間は約30%短縮された。精度と同時にスループットの話でもある。
重みの公開が計算式を変える点
医療AIは長らく、座席単位や検査単位で課金する規制対応済みのクローズド製品が主導してきた。モデルとコード、フレームワークをまとめて公開すればこの構図は動く。元の研究コホート外の病院も、自院の患者集団で検証してから信頼するかどうかを決められるし、研究者はベンダーの仕様書から推測せずに失敗の出方を直接確かめられる。
競争環境も併せて見る必要がある。アリババはQwen言語モデル群から今回の医療モデルまで、分野を問わずダウンロード可能なモデルを押し出している。重みの公開を善意ではなく流通戦略として使っているということだ。
次に来る課題
論文の掲載と現場への導入は別の問題だ。主に中国人コホートで検証されたモデルは、他の人種集団や装置環境で改めて試される必要があり、Scienceの論文を承認とみなす規制当局はどこにもない。当面の現実的な使い方は、放射線科医が確認すべき所見を先に拾い上げるセカンドリーダーとしての役割になる。読影者比較試験が測ったのも、まさにその構成だ。
よくある質問
RADARは本当にオープンソースなのか。
研究チームはScienceの論文と同時に、モデル、コード、技術フレームワークを公開した。他のオープンウェイト公開と同様にローカル展開と独立検証が可能だが、臨床での使用は各国の規制承認に従う必要がある。
RADARは放射線科医より正確なのか。
公開された読影者比較試験では、参加した放射線科医26人のうち23人を平均で上回った。より有用なのは併用条件の結果で、モデルと一緒に読影した医師は検出感度が約10%向上し、読影速度も約30%速くなった。
どんな検査画像が必要か。
RADARは18臓器を含む造影腹部CTを対象に作られている。研究チームは、手作業のアノテーションではなく既存の臨床レポートで教師づけする手法は他の画像検査にも広げられるとみているが、公開されたモデルの適用範囲は腹部CTに限られる。