
OpenAI、話しながら聞く音声モデルを1分5セントで開発者に開放
OpenAIの全二重音声モデルGPT-Live-1が1分0.05ドルでAPI提供されました。Tau3ベンチマークで86.2%を記録し、45.7%だった従来モデルを大きく上回ります。
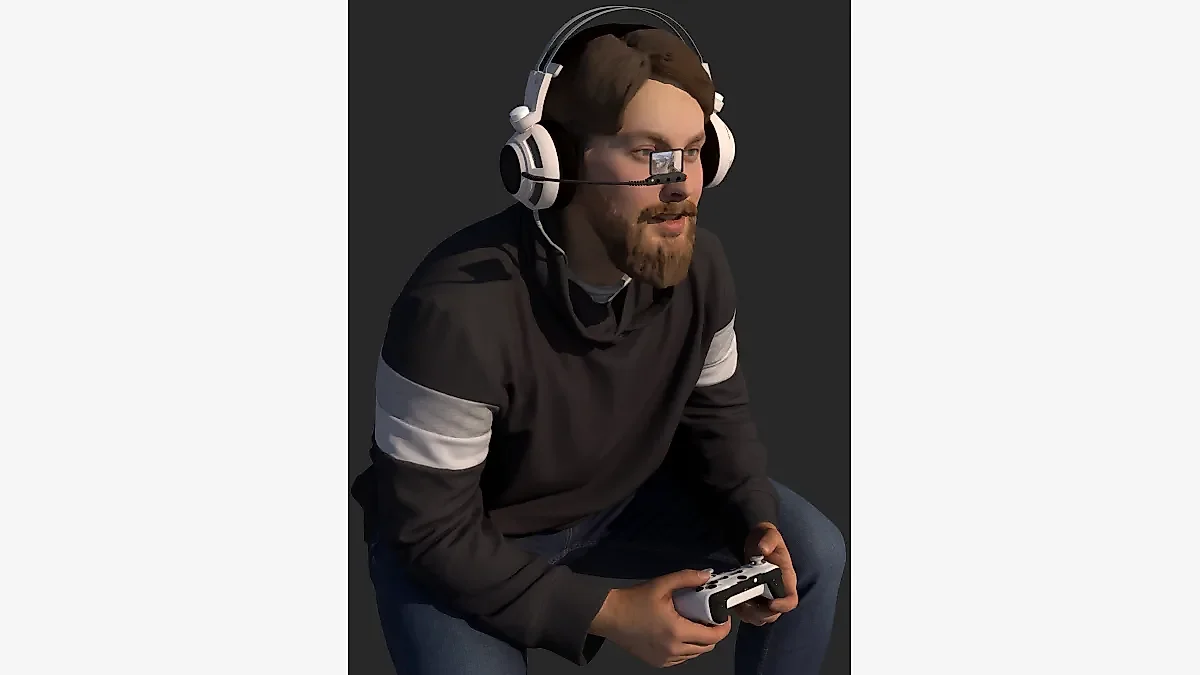
OpenAIはGPT-Live-1をAPIで提供開始しました。順番を待つのではなく、聞きながら同時に話せる音声モデルを開発者が利用できるようになります。このモデルは7月にChatGPT内で登場しましたが、今回のAPI公開により顧客向け製品へ組み込めるようになりました。価格は、実際の処理を担うバックエンドモデルの料金とは別に、利用1分あたり5セントです。
要点
- GPT-Live-1は全二重(フルデュプレックス)方式で、トランシーバーのように交互に話すのではなく、音声を生成しながら入力音声を同時に処理します。
- 音声エージェント向けベンチマークTau3で86.2%を記録しました。GPT-Realtime-2.1は45.7%、GPT-Realtime-2は42.4%です。
- 利用料は1分あたり0.05ドルにバックエンドモデルの料金が加算されます。企業向けエージェント基盤であるOpenAI Presence経由でも提供されます。
全二重が音声エージェントの手触りを変える理由
従来の音声システムは半二重です。一方が話し、もう一方が聞き、切り替えは明示的に行われます。人間の会話はそのようには進みません。言葉は重なり、割り込みが入り、語尾は消え、やわらかく遮られます。こうした動きが一切できないシステムは、回答の質がどれほど高くてもぎこちなく感じられます。
話しながら聞くということは、文を言い終えた後ではなく、割り込みが起きたその瞬間に気づけるということです。OpenAIは語学学習企業Speakでの初期導入を挙げています。学習者が答える前に考える時間を長く取れるようにした結果、ターン方式の従来モデルと比べて割り込みを80%近く減らしたと報告されています。ここでの改善は速さではなく自制、つまり話さないタイミングを知ることにあります。
ベンチマークの差は、一世代分としては異例の大きさです。Tau3は航空会社や小売、通信事業者が運用するような音声カスタマーサービス業務を測定します。40%台前半から86.2%への跳ね上がりは、従来のRealtimeモデルがわずかに及ばなかったのではなく、構造的な部分で失敗していたことを示唆します。OpenAIは別途、Full Duplex BenchでGPT-Realtime-2.1より約30%良い結果と、ターン交代のレイテンシー改善も報告しています。
アプリケーションの中での役割
GPT-Live-1は単独で使う想定ではありません。会話はこのモデルが担い、情報検索やツール呼び出し、タスク管理は別のバックエンドモデルが処理します。難度の高い作業にはGPT-6 Astraを、定型的な作業にはより安価なモデルを組み合わせる形です。この分担により、高価な推論が1分単位の音声料金に乗らず、開発チームは一律の単価を受け入れる代わりに会話あたりのコストを調整できます。
だからこそ価格は注意深く読む必要があります。1分5セントが対象とするのは音声レイヤーだけです。10分のサポート通話は、バックエンドモデルやAIエージェントのロジック、通信料金を除いても50セントかかります。単位あたりの採算は、マイクの後ろにどのモデルを置くかで決まります。カスタム音声も利用できますが、設定で選ぶのではなくOpenAIの営業チームとの交渉が必要です。
名前が公表された最初の利用企業の一つがYelpで、AIによる飲食店予約サービスYelp Hostにこのモデルを使っています。同社のアキル・クドゥバリ・ラメシュ最高製品責任者は、この技術によって通話がより会話らしくなり、スタッフが電話ではなく来店客に時間を使えるようになると述べました。もっとも、The Registerが指摘したように、電話の向こう側にいる客がどう感じているかを尋ねたところはまだありません。
導入前に検証すべきこと
ベンチマークの改善が示すのは平均的な挙動であり、音声システムは端の条件で崩れます。訛り、背景騒音、品質の悪い電話回線、文の途中で黙る話者。半二重システムが従来つまずいてきたのはまさにこうした場面であり、そこでは自信を持って割り込むモデルのほうが、待つモデルより悪い結果になりかねません。意味のある評価には、きれいなスタジオ音声ではなく劣悪な音声を含めるべきです。
二つ目の論点は告知です。予約の電話で人間と取り違えるほど滑らかなシステムは、発信者にその旨を伝えているのかという問題を招きます。すでに複数の法域が告知を義務づけています。これを消費者向けの音声フローに投入するチームは、最初の苦情が来た後ではなく、公開前に方針を固めておくべきです。
大きな流れははっきりしています。OpenAIは、他社がその上に構築するインフラとして機能を包装しています。企業向けエージェント基盤でも、業界各所で登場している常時待ち受け型アシスタントでも同じ構図が見えます。音声は機能ではなくレイヤーになりつつあります。
よくある質問
AI音声モデルにおける全二重とは何ですか
聞くことと話すことを厳密に交互に行うのではなく、音声を生成しながら同時に音声を取り込めるという意味です。これにより文の途中で入った割り込みを検知して応答でき、会話が無線機のやり取りよりも人同士の会話に近く感じられます。
GPT-Live-1の料金はいくらですか
音声モデル自体は利用1分あたり0.05ドルです。これに加えて、検索やツール利用、タスク管理を担うバックエンドモデルの料金がかかります。したがって総額は、GPT-6 Astraのような高性能モデルを組み合わせるか、定型業務向けの安価なモデルにするかで変わります。
GPT-Live-1はOpenAIのRealtime APIとどう違いますか
音声エージェント向けベンチマークTau3で、GPT-Live-1は86.2%、GPT-Realtime-2.1は45.7%、GPT-Realtime-2は42.4%でした。OpenAIはFull Duplex BenchでもGPT-Realtime-2.1より約30%良い結果と、ターン交代のレイテンシー改善を報告しています。
ZZEMが運営するAI Newswayの編集責任者です。AI、開発ツール、クラウド、生産性テクノロジーの記事を執筆しています。
コメント 0
現在コメントの投稿は無効になっています。