
OpenAI「自社モデルがJalapeñoの設計を9か月に短縮した」
AIが書いたカーネルがOpenAIの専門家による実装を最大1.8倍上回った。JalapeñoのInferenceXベンチマーク結果が初公開された。
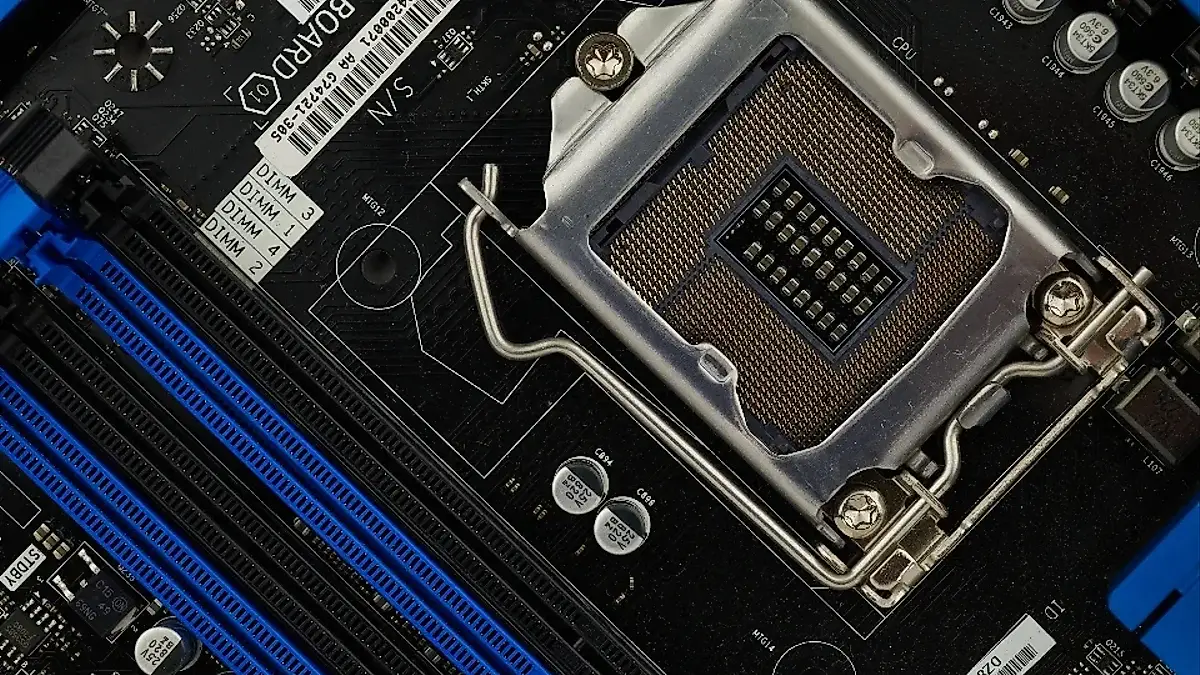
データセンター向けアクセラレータの設計に9か月という期間は、決して長くない。通常かかる時間の半分、場合によってはそれ以下だ。OpenAIは火曜日のHot Chipsカンファレンスで、ハードウェアチームがJalapeñoの初期設計からテープアウトまでをこの期間で終えたと明かし、その圧縮の多くを自社モデルの貢献だとした。
このチップは昨年10月に発表され、Broadcomとの緊密な協業で開発された。今週、OpenAIは初めて実測値を公表した。
シリコンを書くモデル
最も目を引く点は性能グラフではない。OpenAIによれば、GPT-OSSのアテンションおよびMoEブロックの一部をAIが実装したものが、自社の専門家が書いた実装を1.5〜1.8倍上回ったという。
これはカーネル単位の結果だ。モデル全体がそれだけ速くなったという意味ではない。ただし、人間の専門家だけでなく機械にも十分プログラムできる部品を設計目標に据えたことを示している。
製造後も同じ手法が続いた。エンジニアはCodexとGPT-Astra、さらに以前のモデルを用いて、オープンウェイトのモデル3種を2か月で高性能まで引き上げた。3つとも当初のJalapeño量産計画には入っていなかった。設計・測定・検証のループを短縮できたことが、日程を前倒しした要因だとOpenAIは説明する。
ベンチマークが示すもの
OpenAIはSemiAnalysisが運営する公開推論ベンチマークInferenceXで測定した。使用モデルはGPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1Tの3種。
3モデル全体で、Jalapeñoはワットあたり1.5〜1.9倍の処理をこなした。エンドツーエンドの遅延は1.7〜3.6倍縮んだ。対話性の高いワークロードでは、その差は2.1〜4.1倍だと同社は述べている。
資料にはさらに大きな数字も登場するが、読み方に注意が要る。従来最良のトークン間時間(TBT)動作点で測ると、モデル次第でワットあたり8.6〜104.3倍だったという。これは一般的な高速化ではなく、応答性を一定に固定した条件での比較だ。
効率の主張は各アクセラレータの公表電力定格に基づく。Jalapeñoの定格は700ワットだが、実測中に550ワットを超えることはなかった。The Registerは、システム全体でチップ128個、1.7エクサフロップス、HBM 27TBになると伝えている。
アーキテクチャ上の賭け
言語モデルのサービングは、性質の異なる二つの仕事を縫い合わせたものに近い。最初のプロンプトを処理する段階は演算に縛られ、トークンを一つずつ出す段階はメモリ帯域に左右される。コアやパッケージ間のデータ移動は、そのどちらでも時間を食う。
通常はバッチ処理でこれを覆い隠す。利用率は上がるが、個々のユーザーは待たされる。OpenAIはその妥協を覆い隠すのではなく、設計で解いた。生成中に作られるKVキャッシュを含むモデル状態を明示的に配置しローカルに固定でき、ネットワークファブリックは一つのジョブをできるだけ一つの接続システム内に留める。
同社のハードウェアを統括するRichard Ho氏は記者団に対し、今回の数値は現行水準を大きく前進させるものだと語った。電力あたりより多くの顧客をさばきながら、応答は速いまま保てるという説明だ。
まだ決着していないこと
比較の土台には検討の余地がある。Jalapeñoは現在出荷中のNVIDIA Blackwellシステムと比べられた。Ho氏は展開時期を2026年末にごく少量、意味のある量は2027年中としている。
その頃にはNVIDIAのRubin世代が現場に入っているだろう。今日のハードウェアに勝つことと、自社の投入時点で勝つことは別の問題だ。今回の測定はベンダーが自社シリコンに対して行ったもので、業界では通常の慣行とはいえ第三者検証ではない。
OpenAIはそれとは関係なく、NVIDIAをはじめとする供給元からの購入を続けるとしている。Jalapeñoの次世代2つはすでに進行中で、同社はこの製品群をモデル・チップ・メモリを一体で計画する多世代プラットフォームと位置づける。狙いは供給元からの独立ではない。モデルが変わるときにシリコンをどう動かすかを自ら決めることだ。
ZZEMが運営するAI Newswayの編集責任者です。AI、開発ツール、クラウド、生産性テクノロジーの記事を執筆しています。
コメント 0
現在コメントの投稿は無効になっています。