
엔지니어 2명과 Codex가 모든 ChatGPT 데이터 읽기를 떠받치는 서비스를 Rust로 다시 썼다
OpenAI의 스토리지 플랫폼이 2026년 2분기에 Python에서 Rust로 옮겨가며 CPU 효율 6배, 메모리 효율 15배를 얻었다. 마이그레이션은 Codex와 GPT-5.5를 쓴 엔지니어 두 명이 해냈다.
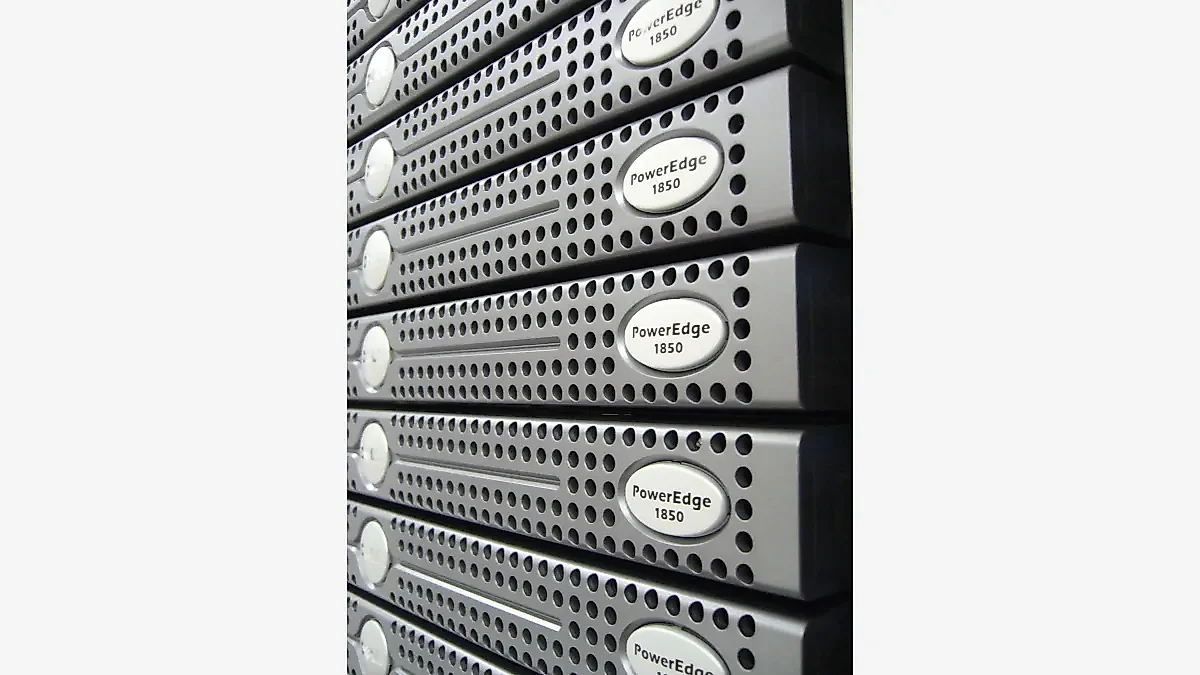
OpenAI가 ChatGPT의 모든 데이터 읽기 요청 앞단에 있던 Python 서비스를 2026년 2분기에 Rust로 다시 썼다. 엔지니어 두 명이 Codex와 GPT-5.5를 써서 끝낸 작업이다. 새 서비스는 현재 운영 트래픽의 95%를 처리하며, 기존 서비스보다 CPU 효율은 6배, 메모리 효율은 15배 높다. Python 구현은 완전히 폐기 단계에 들어갔다.
핵심 요약
- OpenAI의 온라인 스토리지 플랫폼 Habitat은 500페타바이트가 넘는 데이터를 상대로 초당 7000만 건 이상의 요청을 처리한다. 주간 이용자 10억 명 규모의 제품들이 이 위에 올라가 있다.
- Python에서 Rust로의 재작성은 Codex와 GPT-5.5에 기댄 엔지니어 두 명이 수행했고, CPU 효율 6배·메모리 효율 15배 개선을 끌어냈다.
- 더 어려운 교훈은 언어가 아니라 운영에서 나왔다. asyncio 스케줄링 지연, 이미 버거워하는 파드에 부하를 몰아주는 LIFO 커넥션 풀링, Envoy와 Istio를 거치며 발생한 천둥 떼 현상이 그것이다.
Habitat이 하는 일과 존재 이유
Habitat은 OpenAI의 제품과 그 아래 스토리지 시스템 사이에 앉아 있다. Azure Cosmos DB, 블롭 스토리지, 캐싱 계층, 내부 데이터베이스가 그 대상이다. 제품이 데이터를 요청하면 Habitat이 스키마를 해석하고 요청을 라우팅하며 권한을 확인하고 암호화와 직렬화를 처리한 뒤 요청 형태를 다듬고 커넥션 풀을 관리한다. 제품 엔지니어는 백엔드를 하나하나 익히는 대신 인터페이스 하나만 상대한다.
시작은 훨씬 작았다. Habitat은 2024년 중반 Python 클라이언트 라이브러리로 출발했다. 서비스들이 데이터베이스와 통신하기 위해 임포트하는 공용 패키지에 가까웠다. 이 설계는 만들기도 빨랐고 한동안은 개선도 빨랐다. 캐싱이나 압축을 추가하려면 새 버전을 배포하고 각 팀이 가져가도록 하면 됐다.
라이브러리의 문제는 업그레이드가 분산된다는 점이다. OpenAI는 리전 장애를 견디기 위해 핵심 데이터를 여러 리전 데이터베이스 계정에 분산하려 했던 경험을 설명한다. 이 작업에는 데이터를 쓰는 모든 서비스 안에 새 라우팅 로직을 넣고, 하나씩 배포한 뒤 실제 트래픽에 섀도잉하고, 기능 플래그 뒤에서 활성화하는 과정이 필요했다. 수십 개 서비스를 조율하는 데 며칠이 걸렸고, 한 팀은 옛 버그를 품은 버전으로 롤백하면서 애초에 막으려던 바로 그 장애를 냈다. Habitat은 2025년 중반 독립 서비스로 분리됐다. 제품에는 얇은 클라이언트 SDK만 남고, 라우팅·배포·모니터링·접근 제어는 한곳으로 모였다.
규모가 커지자 드러난 실패
OpenAI의 요청량에서 그 서비스를 Python으로 돌리자 벤치마크에서는 보이지 않는 문제들이 드러났다. CPU를 많이 쓰는 백그라운드 작업에서 비롯된 asyncio 스케줄링 지연은 하위 호출이 빨리 돌아와도 테일 레이턴시를 지배했다. 한 사례에서는 모든 파드가 Statsig 기능 플래그 설정을 1분에 한 번 JSON으로 파싱했는데, 지터 없이 파드당 여덟 개 프로세스에서 동시에 수행됐다. 모든 워커가 같은 순간에 멈춰 선 것이다. 해법은 평범하지만 배울 점이 있었다. 설정을 작게 쪼개 필요한 부분만 읽고, 갱신 주기를 늘리고, 타이밍에 난수를 섞었다.
두 번째 실패는 더 미묘했다. Python의 aiohttp 커넥션 풀은 기본적으로 LIFO 순서로 커넥션을 재사용한다. 느리고 과부하된 서버는 커넥션을 늦게 반납하므로 오히려 더 자주 선택된다. 부하를 감당하기 가장 어려운 파드에 트래픽이 몰리는 구조다. FIFO 재사용으로 바꾸자 이 피드백 루프가 끊겼고, 부수적으로 정상 상태의 요청 편차도 줄었다. Envoy와 Istio를 거친 천둥 떼 현상이 목록의 마지막을 채웠다.
OpenAI는 제약처럼 읽히지만 실제로는 안전장치로 기능하는 설계 선택도 했다. Habitat은 의도적으로 제한된 NoSQL API만 노출한다. 비용이 크거나 예측하기 어려운 쿼리는 아예 표현할 수 없다. 이 서비스를 쓰는 제품이 늘어도 요청당 비용이 발산하지 않는 이유다.
엔지니어 두 명, 재작성 한 건
이번 마이그레이션에서 가장 널리 인용될 대목은 인력 구성이다. 주간 10억 명이 쓰는 제품의 임계 경로에 놓인 서비스를 인터프리터 언어에서 Rust로 옮기는 작업을 OpenAI의 자체 코딩 도구를 쓴 엔지니어 두 명이 해냈다. 그동안 일화 수준으로만 다뤄졌던 논쟁에 붙은 구체적 데이터다. 언어 마이그레이션은 대상 언어가 틀렸기 때문이 아니라 이식 노동을 정당화할 수 없어서 기각돼 왔고, 에이전트형 코딩 도구는 그 계산을 바꾼다.
효율 수치는 조심해서 읽을 필요가 있다. CPU 6배·메모리 15배 개선은 직렬화와 I/O 조율이 대부분인 요청 라우팅 작업에서 Python 인터프리터가 짊어지는 오버헤드를 반영한 값이다. Rust 재작성에 거의 최선의 조건에 해당한다. 병목이 데이터베이스나 외부 API인 팀이라면 같은 수익률을 기대하지 않는 편이 좋다.
OpenAI의 경로를 따라가려는 쪽에는 Rust 생태계 자체의 공급망 노출이라는 별개의 숙제가 남는다. 오염된 크레이트가 86분간 살아 있던 사건이 이를 분명히 보여줬다. OpenAI의 엔지니어링 기술 문서는 두 편 중 첫 편이며, 스토리지 계층 자체는 후속편에서 다룬다.
FAQ
OpenAI는 왜 Habitat을 Python에서 Rust로 다시 썼나
해당 서비스의 요청량에서 인터프리터 오버헤드를 더는 감당할 수 없었다. 팀이 부딪힌 운영 실패들, 즉 asyncio 스케줄링 지연과 커넥션 풀의 준안정 상태는 Python 서비스를 편한 범위 밖으로 밀어붙인 증상이었다. Rust 대체본은 CPU 효율 6배·메모리 효율 15배를 기록하며 현재 운영 요청의 95%를 처리한다.
그렇다면 Python은 운영 서비스에 부적합한가
그렇지 않다. Habitat은 연 10배를 웃도는 성장을 3년간 겪는 동안 Python으로 돌아갔다. 오히려 그게 핵심이다. 제품 형태가 아직 움직이는 동안에는 그 언어가 맞는 선택이었고, 규모가 정당화하는 시점에 부채를 의도적으로 상환했다. 이 사례는 순서에 관한 의사결정이며 Python에 대한 판결이 아니다.
Habitat 뒤에는 어떤 스토리지 시스템이 있나
Azure Cosmos DB가 주 데이터베이스 계층이고, 그 옆에 캐싱과 블롭 스토리지, 기타 내부 데이터 서비스가 있다. 제품은 이 시스템들을 직접 호출하지 않는다. Habitat을 부르면 데이터가 어디에 있고 어떻게 닿을지를 Habitat이 해석한다.
댓글 0
현재 댓글 작성이 비활성화되어 있습니다.