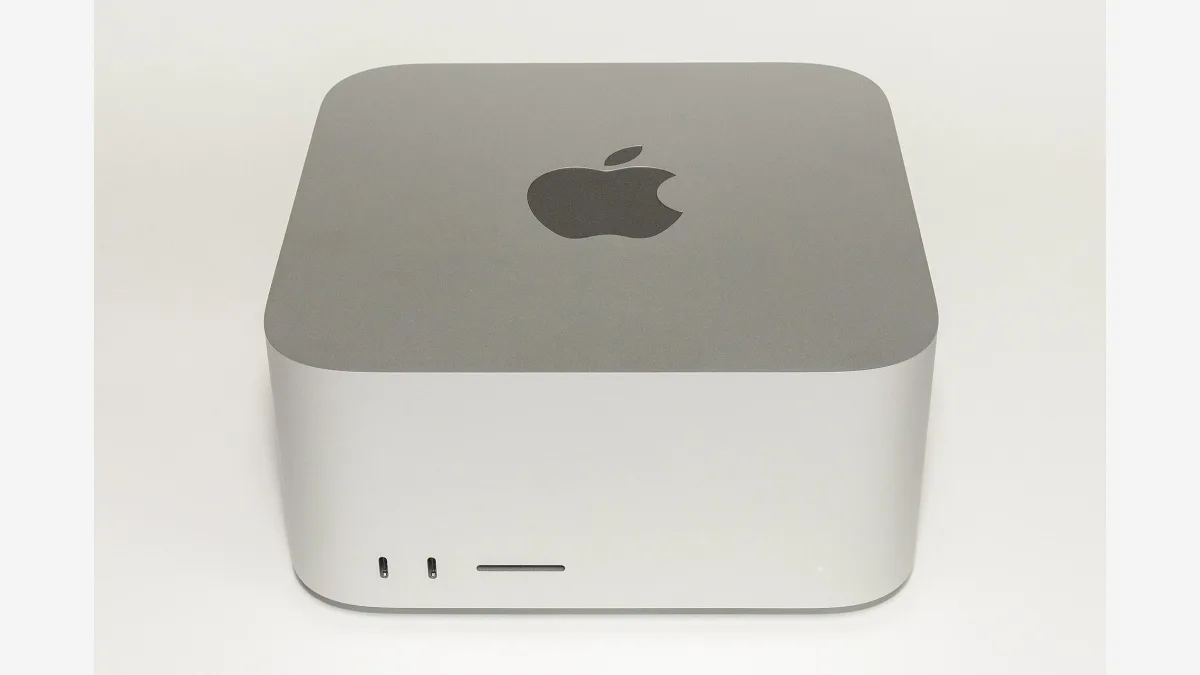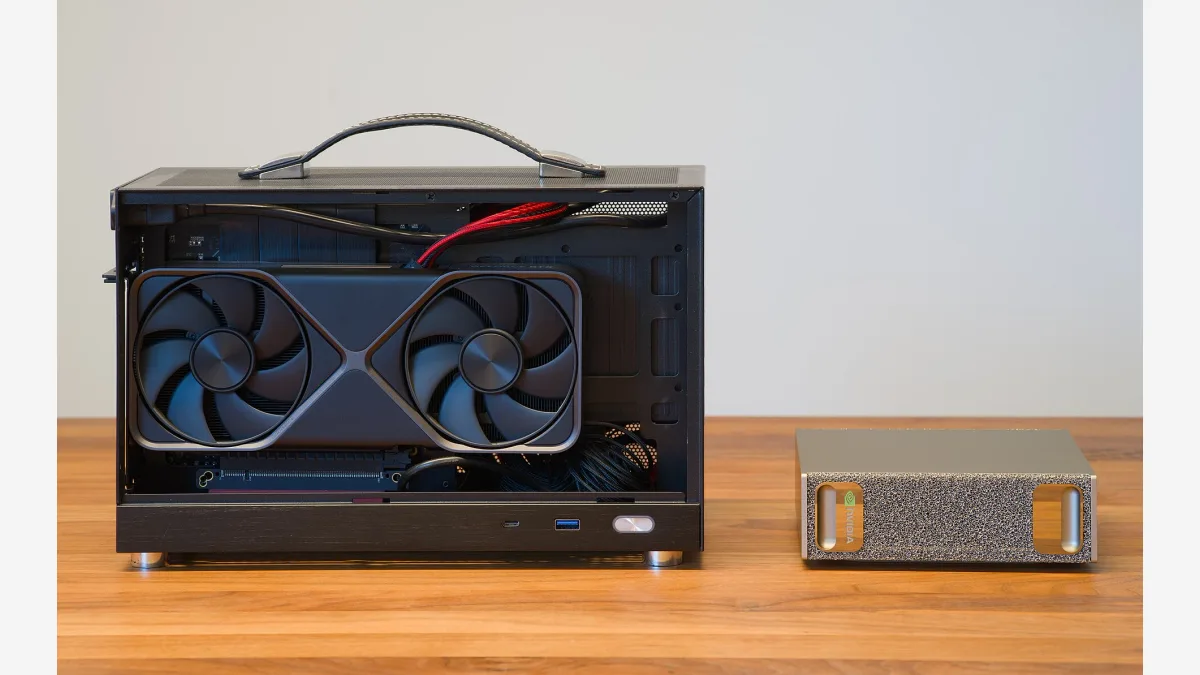
Nvidiaが10月23日金曜日、DGX Sparkの64GB構成を出荷する。販売はAcer、ASUS、Dell、Gigabyte、HP、MSIの6社経由に限られ、価格は4,999ドルから。同社はこれをプラットフォームを手の届く価格帯に保つための措置だと説明している。しかし比較対象を変えると見え方は変わる。メモリをフルに積んだ128GB版DGX Sparkの発売時価格は約4,000ドルだった。つまりメモリが半分の今回のモデルは、1年前の完全版より約25%高い。
要点
- DGX Spark 64GBは10月23日に4,999ドルで登場する。GB10 Grace Blackwell Superchip、20コアのMediaTek製Arm CPU、DGX OS、273GB/sのメモリ帯域は128GBモデルと同じだ。
- Nvidiaは128GB版を6,950ドルへ値上げした。発売時価格の75%近い上昇であり、メモリを半分に削ったSKUが選択肢ではなく必然になった理由でもある。
- 64GBを2台ConnectX-7で束ねるとメモリを128GBにプールできる。最大2,000億パラメータのモデルに対応し、Nvidia自身のQwen3.8 27Bテストでは単体の最大1.7倍の性能を出した。
64GBで手放すもの
シリコンは同一だ。NvidiaはGB10 Grace Blackwell Superchip、MediaTekの20コアArmプロセッサ、ConnectX-7ネットワーキング、CUDAソフトウェアスタックをそのまま維持した。メモリ帯域も273GB/sで変わらない。モジュールの数を減らしたのではなく、容量の小さいLPDDR5xモジュールを使ったということだ。ストレージも半分になっている。
縮んだのは余裕のほうである。64GBの単体機はオンデバイスで最大1,000億パラメータのモデルまで対応し、2台構成の2,000億パラメータとは差がつく。The Registerは、容量が小さいぶんメモリ圧力が最も高いファインチューニングには向かないと指摘した。Nvidiaの反論は、実際のワークロードはローカル推論だというものだ。260億〜350億パラメータ帯のオープンモデルはすでにプライベートなエージェントを動かせる水準にあるとして、Qwen3.8 27Bを挙げている。
クラスタリングという答え
Nvidiaは容量削減を拡張性で埋めようとしている。DGX SparkはすべてConnectX-7 NICを備え、2台をQSFPケーブルで直結すればメモリは128GBにプールされ、帯域は倍になる。NvidiaのQwen3.8 27B計測では単体比で最大1.7倍のスループットを記録した。ハードウェア自体はGB10機器を4台まで、各200Gbpsで束ねられる。
新しいのは、もうCLI作業が要らない点だ。Sync Cluster Assistantが接続された機器を検出し、構成を検証してConnectX-7ファブリックを自動で立ち上げる。全ノードが同じスタックを動かすため、ワークフローを1台から2台へ移しても設定をやり直す必要がない。月末に出るSync Model LauncherはQwen3.8 27Bをクラスタ全体にダウンロードして起動し、OpenCodeに接続する。ブラウザがそのままインターフェースになる。
価格の下限が上がった理由
これは本質的に製品戦略の話ではない。NvidiaのGB10シリーズは、CESでProject Digitsとして披露されて以降ずっと上方へ押し上げられてきた。当時の想定は3,000ドル前後だったが、実際の発売価格は4,000ドル近辺だった。128GBが6,950ドルまで上がったのは利益欲ではなく、DRAMの契約価格を追った結果だ。Micronは供給が2028年までさらに引き締まると警告している。この条件下で5,000ドル以下の価格帯を守れる手段は、メモリを半分にすることだけだった。
これはNvidiaのコンシューマ計画も難しくする。同じGB10シリコンを使ったRTX Sparkのノートブックとミニ PCが、この秋Acer、ASUS、Dell、HP、Lenovo、Microsoft、MSIから出る。AIワークロード専用ではなく一般的なコンピューティングを狙った製品だ。だが128GBのヘッドレス開発機が7,000ドルに近づくなら、同等構成のノートPCは売りにくくなる。Nvidiaが価格に敏感な層向けにメモリを減らした派生モデルを用意すると見られているのはそのためだ。
展望
競争圧力はAMDのGorgon Halo SoCから来る。最上位のRyzen AI Max+ 495は約32GBから192GBまでをカバーし、現在は128GB版DGX Sparkより安いシステムに搭載されている。最大容量ではAMDが勝る。一方The Registerのテストでは、AI処理においてGB10 GPUが大幅に速いという結果が一貫して出ている。開発者にとって実務的な問いは、64GBにクラスタリングという逃げ道を足した選択が、最初からメモリを多く買うより得かどうかだ。128GB1台が6,950ドルで提供する容量に64GB2台で到達するには9,998ドルかかる。小さく始めて後から伸ばす人にしかクラスタリングの論理は成立しない。より深い変化は、机の横に置くAI機器の価格がもはや演算性能で決まらないことだ。価格を決めるのはDRAMであり、購入判断は製品ロードマップへの評価ではなく、コモディティ市場への賭けになった。
FAQ よくある質問
DGX Spark 64GBの価格と発売日は
4,999ドルからで、10月23日金曜日にAcer、ASUS、Dell、Gigabyte、HP、MSI経由でのみ販売される。Nvidiaはこの構成を直販しない。
64GBモデルは128GB版より遅いのか
スペック上はそうではない。同じGB10 Grace Blackwell Superchip、同じ20コアMediaTek Arm CPU、同じ273GB/sのメモリ帯域を使う。Nvidiaがモジュール数を減らすのではなく容量の小さいLPDDR5xを選んだためだ。制約は容量にある。単体で1,000億パラメータ、2台構成で2,000億パラメータ、そしてファインチューニングに回せる余裕も少ない。
2台を束ねるのに必要なものは
機器に内蔵されたConnectX-7ポートをつなぐQSFPケーブルと、NvidiaのSyncアプリだ。Cluster Assistant機能が2台目を検出し、構成を検証して、手動のネットワーク設定やvLLMの設定なしに200GbEファブリックを構築する。