
Mercury 2.5、毎秒1,107トークンで100万トークン4セント
電話エージェントのスタートアップは、Mercuryによって最悪時の応答が数分から1秒に縮んだと述べています。Inception Labsの新しい拡散モデルは、その種の数字を軸に設計されています。
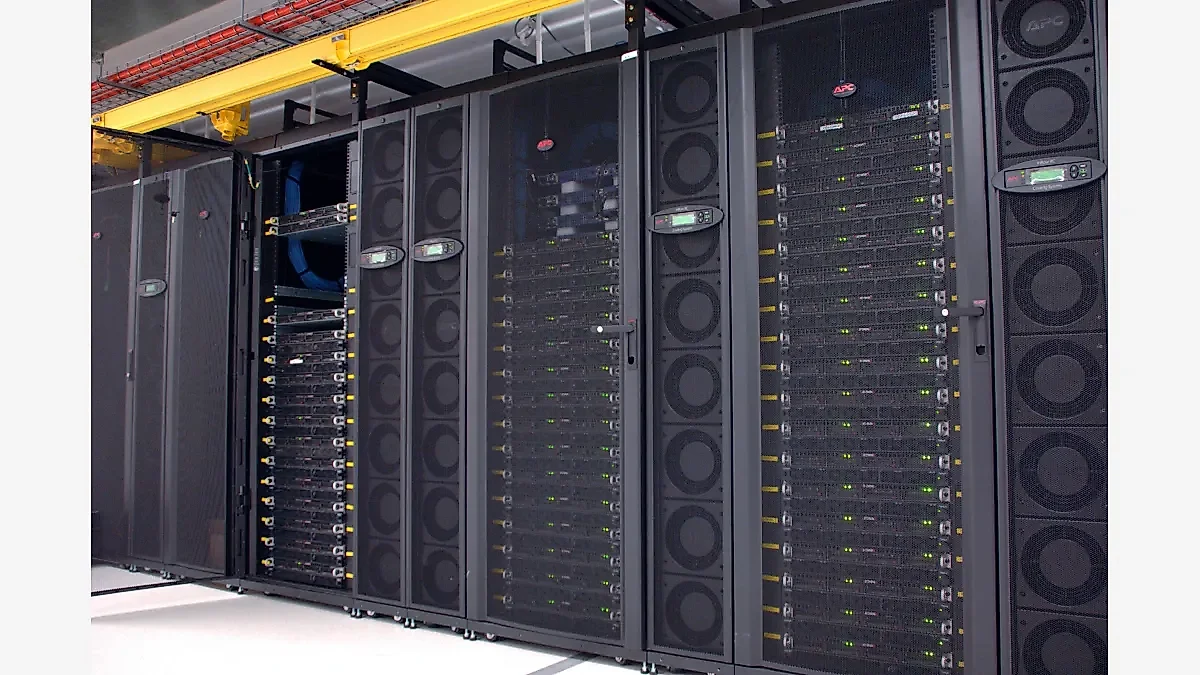
Inception LabsがMercury 2.5で打ち出したのは、やや異色の売り込みです。より賢いモデルではなく、ユーザーの一度のやり取りの中で何十回も呼び出せるほど速くて安いモデルだという主張です。同社はこれを、これまでに学習された拡散言語モデルとして最大規模だとし、広く入手できるNVIDIA GPU上で毎秒1,107トークンを記録すると説明しています。定価は入力100万トークンあたり0.20ドル、出力0.75ドルで、提供開始時は80%割引の0.04ドルと0.15ドルになります。
主なポイント
- Mercury 2.5は低遅延・低コストの提供形態を保ったまま、Mercury 2から知能が40%向上したとしています。
- Inceptionは品質の比較対象を最上位の推論モデルではなく、GPT-5.6 Luna(Low)、Gemini 3.5 Flash-Lite、Claude Haiku 4.5といったコスト最適化ティアに置いています。
- Augment Codeは、コンテキスト圧縮をMercuryに移したことで遅延が約150秒から27秒へと82%短縮され、コストも90%下がったと報告しています。
拡散LLMが遅延で勝負できる理由
従来の大規模言語モデルはトークンを一つずつ順に吐き出すため、話す量に比例して実時間が伸びます。拡散モデルは代わりにテキストのブロック全体を並列のパスで磨き上げます。Inception Labsが専用の推論チップではなく汎用アクセラレータで四桁のスループットを示せるのは、このアーキテクチャの違いによるものです。
同社はMercury 2.5をベンチマーク競争の産物ではなく、フィードバックループの最初の成果だと位置づけています。Mercury 2の提供開始後、数千人の開発者と数十件の企業導入を経て利用量が一桁以上伸び、そこで表面化した実運用の失敗事例を軸に評価を組み直してから学習に入ったとしています。
顧客はどこで使っているのか
検索を見ると、呼び出しごとの遅延がなぜ積み上がるのかがわかります。一つのクエリが計画立案、クエリの書き換え、再ランキング、事実の構造化、要約、回答の検証へと枝分かれし、数十回のモデル呼び出しに広がります。ユーザーが間を感じ取る前にこの連鎖すべてが終わらなければならず、だからこそInceptionは主要な検索インフラ企業の複数がMercuryを本番投入していると述べています。
音声エージェントはさらに厳しい制約です。通話では遅延が無音としてそのまま聞こえてしまいます。ライブの顧客対応向けAI電話エージェントを手がけるOpenCallは、本番ワークロードでモデル応答遅延の中央値を170ミリ秒前後と計測しています。共同創業者兼CEOのOliver Silverstein氏は、切り替えによってP99が数分から1秒に、P50が0.4秒から0.2秒未満に縮んだと語りました。
これまで見たどの提供元よりも明らかに速く、しかもそれは推論モデルを含めての話です。
三つ目の型がコーディングエージェントで、発表の中でもっとも具体的な数字はここにあります。Augment Codeはコンテキスト圧縮をMercuryへ移し、所要時間が約150秒から27秒へと82%縮んだ一方、同社が言うところの品質は変わらないままコストが90%下がったとしています。MCPのツール検索要約は1秒未満で返ってくるそうです。
遅延の下限を狙う二つのプレビュー
本体と同時に公開されたMercury Voiceは、音声対話でもっとも厳しい時間予算に合わせて調整されたdLLMで、最初のトークンまでの時間は170ミリ秒未満です。もう一つのプレビューであるMercury Routerは、拡散モデルで入力プロンプトを読み取り、品質・速度・コストの観点からオープンかクローズドかを問わず下流のモデルを選びます。
NVIDIAのアクセラレーテッド・コンピューティング・グループでシニアプロダクトマネージャーを務めるShruti Koparkar氏は、今回の発表を、新しいアーキテクチャが既存のAIインフラ上でどれだけ速く実運用水準のシステムへ固まりうるかを示す節目として受け止めました。本当の主張はその点にあります。テキスト向けの拡散は長く研究上の興味にとどまり、速度の数字だけで買い手が動いたこともありませんでした。OpenAI自身の超高速ティアも同等の飛躍を得るためにCerebrasのシリコンに頼っていますが、Inceptionはその利得がハードウェアではなくアーキテクチャから来ていると主張しています。
提供形態と次の一手
Mercury 2.5はInception API、Baseten、OpenRouterを通じて提供され、新規API利用者には1億トークンが無償で付きます。企業向けには専有キャパシティ、オートスケーリング、コンプライアンス制御、データ保持期間の設定が用意されています。調整可能な推論、並列ツール呼び出し、スキーマに沿ったJSONも機能に含まれ、最後の項目は構造化出力に依存するエージェントのパイプラインで効いてきます。
後継モデルはすでに学習中です。Inceptionはこれを自社最大のモデルと説明し、数か月以内の公開を見込んでいます。狙いは、拡散の速度とトークン効率を手放さないまま能力を飛躍させることだとしています。
よくある質問
Mercury 2.5の価格はいくらですか
定価は入力100万トークンあたり0.20ドル、出力100万トークンあたり0.75ドルです。提供開始時はそこから80%割引され、入力0.04ドル、出力0.15ドルになります。新規API利用者には1億トークンの無償枠も付きます。
Mercury 2.5はオープンソースですか
いいえ。Mercury 2.5はInception API、Baseten、OpenRouterを通じて提供される独自のホスト型モデルです。企業顧客は専有キャパシティやデータ保持設定を利用できますが、重みは公開されていません。
拡散LLMとは何ですか
拡散言語モデルは、トークンを厳密に左から右へ予測するのではなく、トークンのブロックを並列に反復して磨き上げながらテキストを生成します。アーキテクチャの馴染みやすさをスループットと引き換えにした形で、音声エージェントや検索パイプライン、エージェントの足回りといった遅延に敏感な用途を狙っています。
ZZEMが運営するAI Newswayの編集責任者です。AI、開発ツール、クラウド、生産性テクノロジーの記事を執筆しています。
コメント 0
現在コメントの投稿は無効になっています。