
허깅페이스, DNA와 대화하는 14B 모델 Carbon-X 공개
Hugging Face가 DNA 서열을 자연어로 해석하는 14B 공개 모델 Carbon-X를 공개했다. 벤치마크 평균 66.7점, 비용은 GPT-6.1 Sol의 1,800분의 1 수준이다.
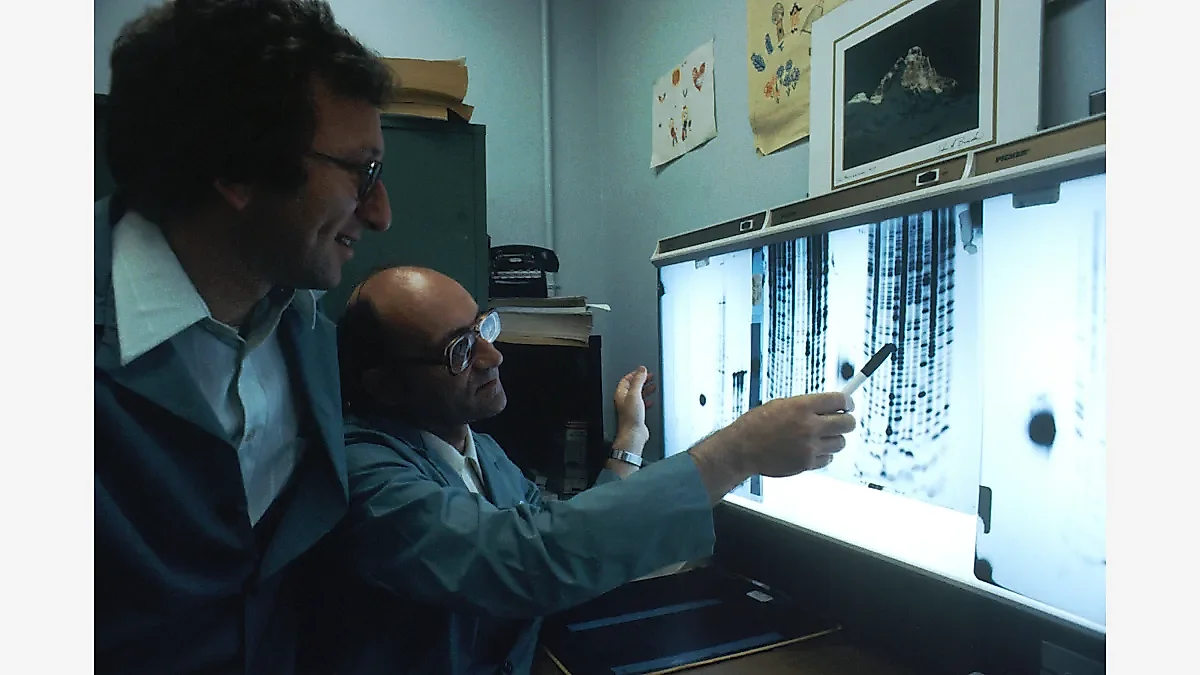
Hugging Face가 10월 22일(현지시간) DNA 서열을 입력하면 자연어로 해석해 주는 140억(14B) 파라미터 공개 모델 'Carbon-X'를 내놨다. 비즈니스인사이더에 따르면 Hugging Face의 루이스 턴스톨 수석 연구원은 이 모델을 연구자가 "DNA와 대화"할 수 있게 하는 첫 사례라고 소개했다.
핵심 정리
- Carbon-X는 알리바바의 Qwen3-14B를 바탕으로 DNA와 텍스트 3,020억 토큰을 추가 학습한 Apache 2.0 라이선스 모델이다.
- Hugging Face가 공개한 DNA 벤치마크 5종 평균은 66.7점으로 GPT-6.1 Sol(67.5점)과 0.8점 차이였고 Opus 5.5(60.9점)보다 높았다.
- 개발진은 문제당 추론 비용을 GPT-6.1 Sol의 약 1,800분의 1로 추산했으며, 가중치는 80GB GPU 한 장에 올라간다.
Carbon-X는 어떤 DNA 언어 모델인가
Carbon-X는 별도의 DNA 인코더 없이 DNA 서열과 영어 문장을 한 모델에서 함께 읽고 쓰는 디코더 전용 언어 모델이다. Hugging Face의 Carbon-X 모델 카드에 따르면 변이가 양성인지 병원성인지 예측하고, 유전자 조절 영역을 찾고, 생물군을 분류하고, 다음 염기를 예측한 뒤 그 판단 근거를 문장으로 설명한다. 개발에는 중국 중관춘연구원(Zhongguancun Academy), 이탈리아 텔레톤 유전의학연구소(TIGEM)와 나폴리 페데리코 2세 대학이 참여했다.
핵심은 혼합 토큰 사전이다. 기존 Qwen3 어휘에 DNA 전용 토큰 5,515개를 더했고, 이 가운데 4,096개는 염기 6개를 한 덩어리로 묶은 6-mer다. 전체 어휘는 15만 7,184개다. 학습 데이터 3,020억 토큰 중 55%가 DNA 원시 서열, 20%가 일반 영어, 15%가 생물학 텍스트, 10%가 지시문 데이터였다. 이후 지도 미세조정과 검증 가능한 보상을 쓰는 강화학습(GRPO)을 거쳤다.
Carbon-X 성능, GPT-6.1 Sol과 비교하면
Carbon-X는 모델 카드에 실린 5개 DNA 벤치마크 가운데 2개에서 비교 대상 모델 전체를 앞섰다. 사고 모드를 끄고 문제당 1회 답한 결과다.
| 벤치마크 | Carbon-X | 최고 비교 모델 |
|---|---|---|
| BioReason Coding(변이 1,018개) | 74.9 | GPT-6.1 Sol 71.0 |
| NextBase(서열 600개) | 39.4 | GPT-6.1 Sol 32.9 |
| GenomeQA(질문 2,600개) | 63.6 | GPT-6.1 Sol 67.2 |
| FrontierVEP(변이 1,000개) | 70.4 | Opus 5.5 76.2 |
| 평균 | 66.7 | GPT-6.1 Sol 67.5 |
같은 표에서 Gemini 4 Argon은 평균 49.8점, Kimi K3는 50.4점이었다. 다만 FrontierVEP와 NextBase는 개발진이 직접 만든 벤치마크라 외부 검증이 더 필요하다.
비용과 보안, 연구자에게 달라지는 점
Hugging Face는 미국 유전 변이 데이터베이스 ClinVar의 '의미 불명 변이' 240만 건을 Carbon-X로 분석하면 약 300달러가 든다고 추산했다. 같은 작업을 비교 대상 프런티어 모델로 하면 3만 2,000달러에서 400만 달러가 든다는 계산이다. 가중치를 내려받아 자체 장비에서 돌릴 수 있어 민감한 환자 유전체 데이터를 외부 AI 기업에 보내지 않아도 된다는 점도 강조했다.
턴스톨은 비즈니스인사이더에 범용 챗봇이 정당한 생물학 질문을 생물무기 설계 시도로 오인해 답을 거부하는 일이 있다고 지적했다. 그는 오용을 막기 위해 학습 데이터에서 바이러스를 명시적으로 제외했다고 밝혔다.
한계와 남은 과제
Hugging Face는 모델 카드에서 Carbon-X가 임상 검증을 거치지 않았으며 의료 결정에 쓰면 안 된다고 못 박았다. 유전체 질문 세부 과제 중 스플라이스 부위(29.8점)와 히스톤 표지(34.6점) 정확도는 낮았고, 긴 DNA 서열을 생성하면 품질이 떨어진다. 염기 개수 세기나 좌표 계산 같은 정확한 연산에서 틀릴 수 있고, 맥락이 없으면 서열의 정체를 지어낼 수 있다는 경고도 붙였다.
전망
Carbon-X는 앞서 공개한 Carbon-500M·3B·8B DNA 기초 모델 계열의 연장선에 있다. 거대 연구소가 변이 효과를 대규모로 미리 계산해 두는 접근(딥마인드의 DNA 변이 90억 개 지도)과 달리, 연구실이 직접 내려받아 질문하는 소형 공개 모델이라는 점이 차별점이다. 턴스톨은 개인 유전체로 치료법을 찾는 맞춤 의학을 '성배'로 표현하면서도 이번 모델은 그 방향의 작은 한 걸음이라고 말했다. 실험실 검증 결과가 쌓이는지가 실제 연구 현장 채택을 가를 전망이다.
자주 묻는 질문
Carbon-X는 무료로 쓸 수 있는 오픈소스인가?
그렇다. Carbon-X 가중치는 Apache 2.0 라이선스로 Hugging Face 허브에 공개돼 상업적 이용도 가능하다. Transformers, vLLM, SGLang에서 실행할 수 있다.
Carbon-X를 돌리려면 어떤 하드웨어가 필요한가?
모델 카드 기준으로 bfloat16 가중치가 80GB GPU 한 장에 들어간다. 양자화 버전도 허브에 올라와 있지만, 전용 DNA 토크나이저 때문에 llama.cpp 같은 GGUF 런타임은 공식 지원 대상이 아니다.
Carbon-X로 유전자 검사 결과를 진단할 수 있나?
안 된다. Hugging Face는 Carbon-X가 임상 검증을 받지 않았다며 의료 결정에 쓰지 말라고 경고했다. 연구용 가설 탐색 도구로 보는 것이 맞다.
댓글 0
현재 댓글 작성이 비활성화되어 있습니다.