
MS 진단 AI, 난도 사례 정답률 83%…의사 평균은 36%
마이크로소프트 진단 AI MAI-DxO가 사이언스 논문에서 NEJM 난도 사례 정답률 83.2%를 기록했다. 참고 자료를 쓴 일반의 평균은 36.1%였다.
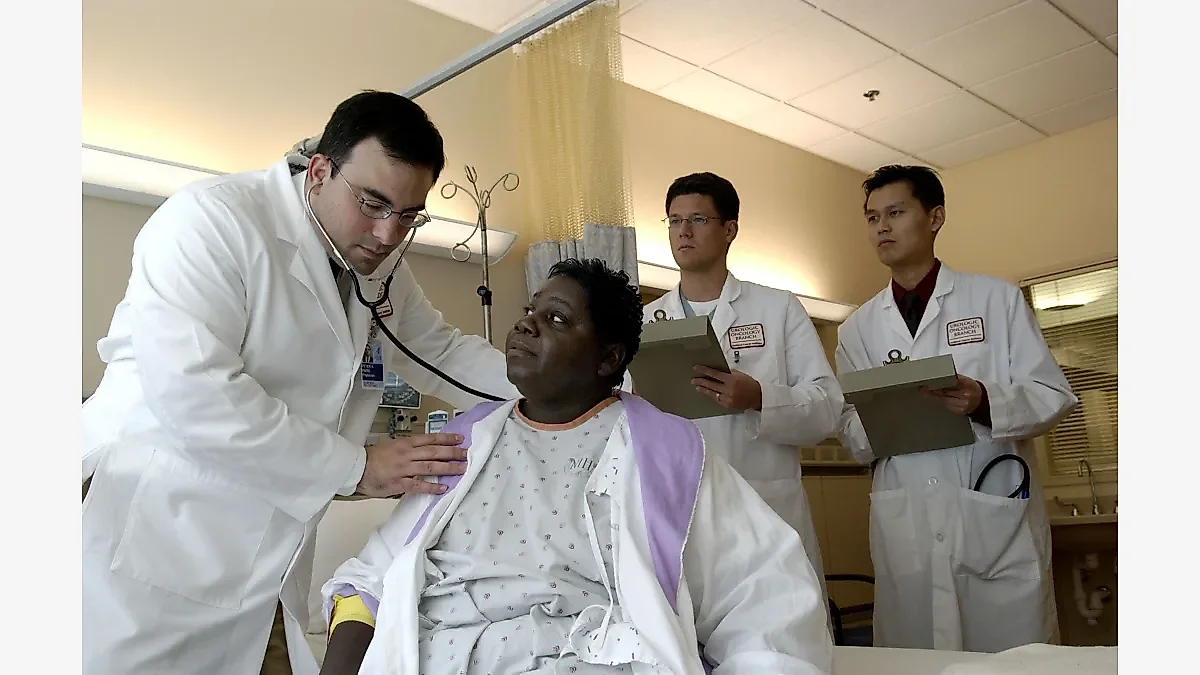
마이크로소프트 연구진이 개발한 진단 AI 시스템 MAI-DxO가 난도 높은 임상 사례에서 정답률 83.2%를 기록했다는 논문이 10월 22일(현지시간) 국제 학술지 사이언스(Science)에 실렸다. 같은 사례를 참고 자료를 쓰며 푼 미국·영국 일반 의사들의 평균 정답률은 36.1%였다. 2025년 6월 프리프린트로 처음 공개된 연구가 동료 심사를 거쳐 정식 논문이 된 것이다.
핵심 정리
- MAI-DxO는 NEJM 임상병리 사례 304건에서 GPT-5 기반으로 83.2%를 맞혔고, 참고 자료를 쓴 의사들의 평균은 36.1%였다.
- 응급실 사례 325건에서는 MAI-DxO가 80.3%, 의사 16명의 평균이 46.79%로 격차가 1.7배 수준으로 줄었다.
- 연구진은 실제 진료 효과와 환자 예후에 대한 영향은 추가 검증이 필요하다고 밝혔다.
MAI-DxO 진단 AI는 어떻게 시험했나
연구진은 환자 정보를 한꺼번에 주는 기존 의료 AI 시험 대신, 정보를 조금씩 얻어 가며 진단하는 순차 진단 벤치마크 SDBench를 새로 만들었다. 미국 의학 학술지 NEJM의 임상병리 집담회(CPC) 사례 304건과 공개 응급실 데이터셋 MIMIC-IV-ED의 응급실 진료 사례 325건 등 모두 629건을 단계별 문제로 바꿨다. AI와 의사는 짧은 첫 소견만 받고 시작해 직접 문진하고 검사를 주문해야 한다. 별도의 '게이트키퍼' 모델이 전체 기록을 쥐고 요청받은 정보만 알려 준다.
평가에는 비용 개념도 들어갔다. 진료 1회는 300달러로 고정하고, 각 검사는 미국 대형 의료기관이 공개한 2023년 가격표에 맞춰 값을 매겼다. 정답률과 함께 사례당 검사 비용을 나란히 비교한 이유다.
가상 의사 다섯 명이 토론하는 구조
MAI-DxO는 하나의 언어 모델이 다섯 가지 의사 역할을 나눠 맡아 토론하는 에이전트 구조다. 감별 진단 후보를 관리하는 역할, 검사를 고르는 역할, 반대 근거를 찾는 역할, 비용을 통제하는 역할, 논리 오류를 점검하는 역할이 매 단계 의견을 낸다.
AAAS가 배포한 사이언스 논문 보도자료에 따르면 MAI-DxO의 정답률은 예산 설정에 따라 79.6~84.5%, 사례당 평균 비용은 1,303~8,945달러였다. 참고 자료 없이 푼 의사들은 22.3%에 그쳤고, 가장 잘한 의사 한 명도 51.8%였다. 연구진은 MAI-DxO가 첫 검사를 주문하기 전에 의사보다 훨씬 많은 병력 정보를 모았다고 설명했다.
정확도 향상은 GPT-5 덕분인가
성과의 상당 부분은 바탕 모델에서 나왔다. 저자 공개 논문 원문에 따르면 GPT-5 단독 정답률은 78.9%(사례당 8,409달러)였고, MAI-DxO를 얹으면 83.2%(5,430달러)가 됐다. 정답률은 4.3%포인트 오르고 비용은 3천 달러가량 줄어든 셈이다. 연구진은 Anthropic, 구글, 메타, 딥시크 모델에도 같은 구조를 적용해 개선 효과를 확인했다.
테크크런치는 응급실 사례에서는 MAI-DxO의 추가 이득이 크지 않았다고 짚었다. 비교 대상이 전문의나 진료팀이 아닌 일반의 개인이라는 점도 한계로 꼽혔다.
실제 병원 적용은 언제
연구진은 MAI-DxO를 의사를 대체하는 도구가 아니라 진료를 돕는 보조 수단으로 제시했다. 신체 진찰을 하거나 환자를 직접 관찰할 수 없고, 게이트키퍼가 기록에 없는 검사 결과를 그럴듯하게 만들어 내는 구조적 한계도 있다. 테크크런치에 따르면 마이크로소프트는 보스턴 베스 이스라엘 디코니스 메디컬센터와 손잡고 동의한 환자를 대상으로 실제 진료 환경 시험을 준비하고 있다. 마이크로소프트 AI를 이끄는 무스타파 술레이만은 이번 결과를 '의료 초지능'으로 가는 단계라고 평가했다. 업무형 AI를 사람 기준으로 재는 시도는 기업 업무용 AI 에이전트 벤치마크처럼 다른 분야에서도 이어지고 있다.
자주 묻는 질문
MAI-DxO는 지금 병원에서 쓸 수 있나?
아니다. 사이언스 논문의 결과는 임상 사례를 이용한 시뮬레이션이며, 연구진은 실제 진료 효과와 환자 예후에 미치는 영향을 추가로 검증해야 한다고 밝혔다.
MAI-DxO는 어떤 AI 모델을 쓰나?
대표 결과는 OpenAI의 GPT-5를 바탕으로 했다. 연구진은 Anthropic, 구글, 메타, 딥시크 등 다른 회사 모델에도 같은 구조를 적용해 성능이 오르는 것을 확인했다.
의사보다 두 배 정확하다는 말은 맞나?
NEJM 난도 사례에서 참고 자료를 쓴 일반의 평균(36.1%)과 비교하면 2배를 넘는다. 다만 응급실 사례에서는 80.3% 대 46.79%로 차이가 줄고, 전문의나 진료팀과는 비교하지 않았다.
댓글 0
현재 댓글 작성이 비활성화되어 있습니다.