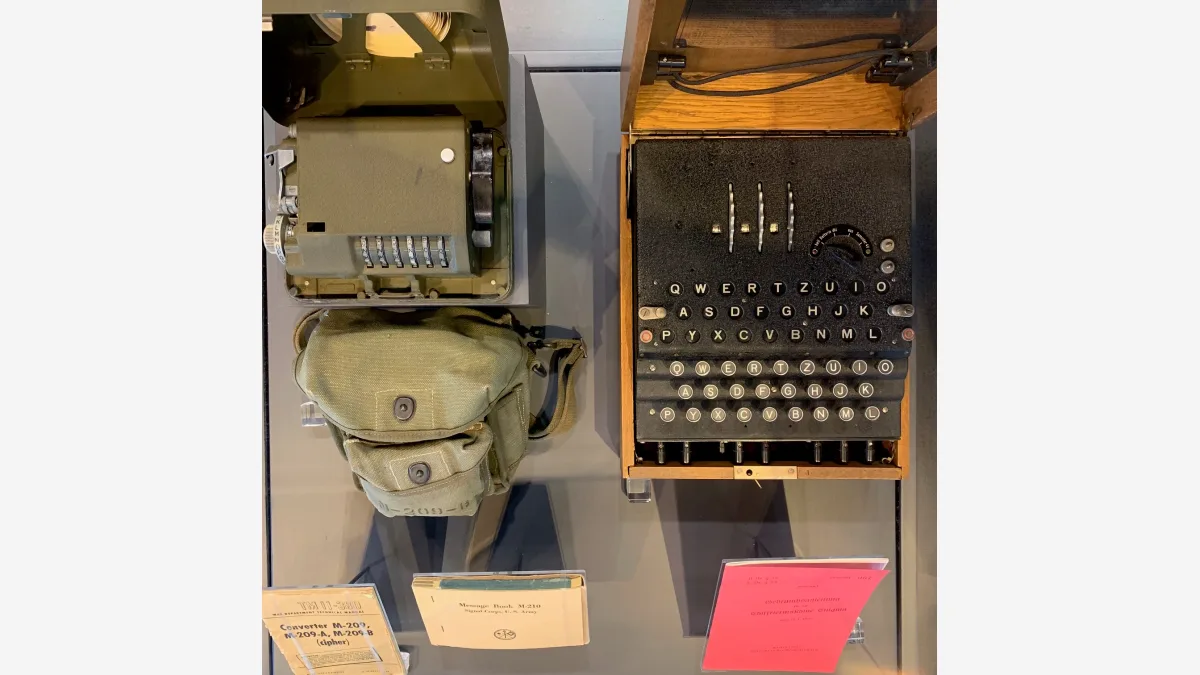
1941年7月10日に発信されたドイツ陸軍のエニグマ暗号無線電文が、ついに読まれました。暗号解読者フロード・ヴァイエルード氏の未解読リストに2005年から載っていた電文で、解読したのはOpenAIのGPT-6 Astraです。Crypto Cellar Researchのアーカイブを運営するヴァイエルード氏は、2026年9月15日にブルームバーグLPのプロダクト開発コーチであるカーター・レフェン氏から連絡を受け、解読結果を検証しました。
電文は82文字で、識別子MVUEHで区別されます。戦術用呼出符号2nyを使う局から送信され、同日17時30分にSS髑髏師団の兵站部無線局が受信電文第172号として記録しました。平文の中身は平凡です。行軍路の指定を求める依頼、発信者がローゼノウにいるという知らせ、そして直ちに無線で返信せよという要求だけです。
要点
- MVUEHはホイール順序253を使っていました。1941年7月10日に解読された他の電文はすべてホイール順序512です。
- GPT-6 AstraはエニグマのシミュレーターとソフトウェアBombeをPythonとC++で自ら書き上げ、繰り返し現れる地名ROSENOWをクリブとして解読を実行しました。
- ヴァイエルード氏は、モデルが指示なしに最初から最後までやり遂げたと記しています。一方、レフェン氏自身の記録は、人間が目標を定め、AIエージェントが証拠集めと探索と検証を担ったと説明しています。
MVUEHが20年持ちこたえた理由
1941年7月10日に復元された他の電文は、すべて同じホイール順序512でした。MVUEHだけが違いました。その鍵はホイール順序253で、プラグ接続もリング設定も異なっていました。2017年にアレックス・ショフコプリャス氏が隣の第173号電文、識別子SIPVXを解読した際、その日の設定から外れた鍵がすでに明らかになっていましたが、それをMVUEHに当てはめても何も出てきませんでした。
残る二つの障害は、解読後になって初めて見えてきました。元の電文用紙から暗号文を書き写す過程に複数の誤りがあり、さらにエニグマの左側ホイールが72文字目で繰り上がっていたのです。まれにしか起きないこの現象は、探索を著しく難しくします。ヴァイエルード氏は、この二点こそ過去の試みが失敗した理由だと見ています。
どうやって解いたのか
エニグマの1日あたりの設定は約1.59×10²⁰通りに達し、総当たりは初めから選択肢になりません。突破口はクリブでした。すでに解読済みのSIPVX電文に地名ローゼノウが2回続けて現れており、同じ語句がMVUEHにも出ると推測したのが出発点です。どの文字も自分自身には暗号化されないというこの機械の決定的な弱点が、大半のクリブ位置を即座に排除しました。
ある位置ですべてが噛み合いました。復元した設定は残りの文字を筋の通ったドイツ語に解き、そこにはAngabe des MarschwegesとSofort Funkantwortが含まれていました。別に保存されていた電文ヘッダーが、この鍵を裏付けました。
MVUEHの平文は、SIPVXの平文とほぼ同じでした。両者が12文字だけ異なるのは、通信手がMVUEHでBitteをBtteと打ち間違え、SIPVXでは署名Waschbuschが繰り返されているためです。レフェン氏は、残ったタイプミスであるBTTEとWASCHBBSCHを解読が本物である証拠と見なしています。捏造した平文ならきれいに読めるはずだから、という理由です。
どこまで自律的だったのか
二つの説明が分かれるのはここです。ヴァイエルード氏は、GPT-6 Astraが完全に独力でやり遂げたと書いています。未解読リストから最も有望な標的としてMVUEHを自ら選び、SIPVXとの関係を疑い、他の手法が失敗した後にローゼノウのクリブに行き着いた、というわけです。The Decoderがまとめたレフェン氏自身の記録は、はるかに抑制的です。目標を立てて判断を下したのは自分であり、専門化したエージェントが証拠集め、探索、突き合わせを担当したと述べています。
投じた労力の規模については、両者の見方が一致します。「Extra High」構成を使い、モデルがこの問題に費やした時間はおよそ10時間でした。モデルが後に参照した連邦公文書館の所蔵資料を数週間かけて調べたヴァイエルード氏は、モデルが2日でやったことを人間の研究者がやれば数週間から数か月かかると語っています。レフェン氏は、解読そのものより結果を説明するウェブサイトに99倍の手間をかけたと明かしました。
次に来るもの
ヴァイエルード氏はまだモデルのログを読んでいる途中ですが、すでに目を引く項目が一つあります。GPT-6 Astraが連邦公文書館の資料番号RS 3-3/20aとRS 3-3/63bを引用したのですが、いずれも正しい番号である一方、Crypto Cellarのサイトのどこにも載っていません。どこから入手したのかは不明です。公開されたパッケージは鍵の探索を再現し、計算を検証しますが、この解が唯一であることや歴史的な同定が確かであることまでは示していないため、独立した検証はなお残されています。この成果は、このモデルが開かれた課題にどこまで届くのかをめぐる他の主張と同じ週に出てきました。そこにはコンピューター操作を前面に出したOpenAIのAstra販売戦略も含まれます。
FAQ — よくある質問
GPT-6 Astraがエニグマを初めて破ったのですか?
いいえ。エニグマは1932年にポーランドの数学者マリアン・レイェフスキが最初に破っており、一般的な手法は何十年も前から公になっています。今回新しいのは、2005年以来あらゆる試みを退けてきた特定の電文1通の鍵を復元した点です。
結果は独立に検証できますか?
部分的には可能です。レフェン氏はコードと探索データ、動作するエニグマシミュレーターを公開しており、これらで鍵の探索を再現し計算を検証できます。ただし、この平文が唯一の解であることや電文の歴史的な素性までは証明しないため、完全な検証は他の暗号解読者による精査にかかっています。
解読された電文自体に歴史的な重要性はありますか?
中身だけを見ればありません。ローゼノウにいた発信者が行軍路を尋ねる、ありふれた兵站上の照会です。意義は方法論にあります。AIシステムが標的の選定から道具の製作、検証まで、暗号解読の工程を一貫して自ら回したことを示しています。