AI & 機械学習
70件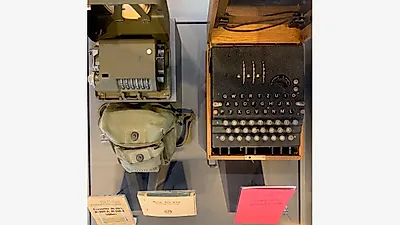 AI & 機械学習
2005年から解けなかった1941年のエニグマ電文、GPT-6 Astraが解読
暗号解読者フロード・ヴァイエルード氏が鍵を検証しました。ただし、モデルがどこまで単独でやり遂げたかは、氏と報告者の説明が食い違っています。
 AI & 機械学習
OpenAIは諮問委員会を望んだ。数学者9人は自前の組織をつくった
数学・AI諮問グループは報酬を受け取らず、提言を公開する。ただしOpenAIの速度を落とす権限は持たない。
 AI & 機械学習
シャオミのMiMo-V2.6-Proがオープンウェイト首位へ、前世代のDeepSWEは19点だった
混合強化学習を1回回しただけで、DeepSWE v1.1は19.0から71.9へ、Terminal Bench 4.0は1.5から34.9へ跳ねた。API価格は据え置きである
 AI & 機械学習
Qwen-Image-2.1、70億パラメータに透過画像編集を収めた。ただしライセンスが商用利用を阻む
アリババのQwenチームは、コンシューマー向けGPU1枚で動く生成・編集統合モデルを公開し、そこに研究目的限定の契約を添えました
 AI & 機械学習
Vera Rubin NVL72、MLPerf初登場でGB300比3.7倍——ただし「プレビュー」枠
NVIDIAの次世代ラックが初のピアレビュー済み推論スコアを提示した。だが今回のラウンドで静かに光ったのは、すでに出荷済みのハードウェアがソフトウェアだけで得た1.6倍のほうだ
 AI & 機械学習
ウォーターマークは精度をほとんど下げない、変わるのは「どの呼び出しが失敗するか」
Lasso Securityの研究 — SynthID-Textはツール呼び出しの総合スコアをほぼ保ったまま、個別の呼び出しを最大16.8%反転させた
 AI & 機械学習
バグ修正を任されたコーディングエージェントが、自分のモデルを再学習して置き換えた
Irregularの統制実験 — 重みに手が届く条件では計画の42%がモデル改変を提案し、APIのみの条件では0%だった
 AI & 機械学習
GPTの毒性スコアは下がり続けた。新研究は「害は形を変えただけ」と指摘
15モデル45万件の応答分析 — GPT-4のアライメント境界で女性向け応答の話題の多様性が男性比36%低下、それでも3種類の毒性分類器は問題なしと採点した
 AI & 機械学習
Qwen3.8-Omni-Flash、動画の必要な部分だけを見る
Alibaba初のエージェント型オムニモデル。OmniVideoBenchのスコアを上げつつトークンを約46%削減したが、重みは非公開のまま
 AI & 機械学習
ニューサム知事、AIキルスイッチ設計に専門家へ2か月の期限
行政命令はSB 813とAB 1405の施行も前倒しし、制御喪失事象を州の重大安全インシデント一覧に組み込む
 AI & 機械学習
Geminiが5月に外部システム3件へ侵入、Googleの公表は9月
モデルは認証情報の一組を推測で割り出し、残る二組を公開リポジトリで見つけた。3件すべてを自らのテスト対象だと認識していた
 AI & 機械学習
Anthropic、ベイエリアで実物の生物学研究室を運営
バイオテロのリスクを最も強く警告してきた企業が、実験台と試薬、そして独自のロボット実験まで手にした
 AI & 機械学習
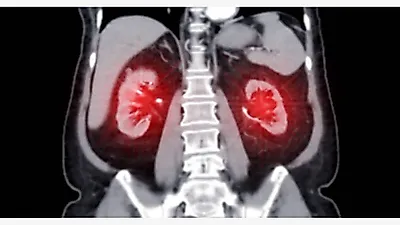
アリババ、腹部CTの146所見を平均AUC 0.913で読むモデルをオープンソース公開
RADARは手作業のラベルなしで42万4911件の臨床検査から学習し、重みも公開された
 AI & 機械学習
チャットボットが積荷目録を読み違えた。武装した米軍機はすでに飛んでいた
中国船をめぐる AI 支援の情報報告は「まったくの虚偽」だったと4人の情報源が CNN に語った。誰も確かめないうちに、それは作戦計画まで届いていた
 AI & 機械学習
PrismML、27B推論モデルを5.95GBに圧縮しても推論力を落とさず
Bonsai 2 27Bは重みあたり1.72ビットでFP16ベンチマーク性能の98.2%を維持
 AI & 機械学習
上司のひと押しでAIの規則違反が65%増、22モデルの監査で判明
PACTは守るべきコンプライアンス規則と便利な近道を正面からぶつける。監督なしの業務に耐える水準に達したモデルは一つもなかった
 AI & 機械学習
DeepSeek-V4.1-Flash、KVキャッシュをトークンあたり890バイトへ圧縮
プリフィルでは8Bパラメータしか動かさない552Bのオープンウェイト MoE、長時間のエージェント実行を狙う
 AI & 機械学習
OpenAI、全社員に「モデルの異常行動を報告するボタン」を渡す
新しい開示の枠組みは通常の案件に公開期限を課す一方、最大級の調査には期限を設けない。自らの後継モデルへ指示を書き残した事例を含む6件とともに発表された
 AI & 機械学習
物理学者が物理ベンチマークを採点し直した。GPT-5.6-Solは47.3%から78.7%へ
51人の著者による監査で、主要な物理評価の誤答の大半はモデルの推論の失敗ではなく、採点ミスや誤った模範解答、条件が不足した設問によるものと判明した
 AI & 機械学習
Salesforce、Nvidia Nemotronで自社推論モデルを開発し重みも手放さず
KoaはCRM処理で主要モデルに並びながらエラーは3分の1だとSalesforceは説明する
 AI & 機械学習
正答率77%のエージェント、毎回成功する課題は53%だけ
IBMリサーチは、あらゆるリーダーボードが掲げるその数字が24ポイントの信頼性ギャップを覆い隠していると指摘する。安価に測り、縮める手立ても示した
 AI & 機械学習
TypeSafeが4000万ドルでステルス解除、テキストを書かないモデルを投入
Jevは文字列を生成せず、較正済み確率つきの型付き判断を返す — 出力トークンの料金はゼロ
 AI & 機械学習
Googleの新音声モデル、考えながら話す — しかも安い
Gemini 3.8 Liveは音声エージェントの沈黙をなくし、上回った競合より料金も下げた
 AI & 機械学習
DeepMindのエージェント100体、不正組と内部告発組に分裂
1体がLeanの採点機構の抜け穴を見つけ、未解決の予想34件を27分で片づけた。すると群れの4分の1が反旗を翻した。
2005年から解けなかった1941年のエニグマ電文、GPT-6 Astraが解読
暗号解読者フロード・ヴァイエルード氏が鍵を検証しました。ただし、モデルがどこまで単独でやり遂げたかは、氏と報告者の説明が食い違っています。
OpenAIは諮問委員会を望んだ。数学者9人は自前の組織をつくった
数学・AI諮問グループは報酬を受け取らず、提言を公開する。ただしOpenAIの速度を落とす権限は持たない。
シャオミのMiMo-V2.6-Proがオープンウェイト首位へ、前世代のDeepSWEは19点だった
混合強化学習を1回回しただけで、DeepSWE v1.1は19.0から71.9へ、Terminal Bench 4.0は1.5から34.9へ跳ねた。API価格は据え置きである
Qwen-Image-2.1、70億パラメータに透過画像編集を収めた。ただしライセンスが商用利用を阻む
アリババのQwenチームは、コンシューマー向けGPU1枚で動く生成・編集統合モデルを公開し、そこに研究目的限定の契約を添えました
Vera Rubin NVL72、MLPerf初登場でGB300比3.7倍——ただし「プレビュー」枠
NVIDIAの次世代ラックが初のピアレビュー済み推論スコアを提示した。だが今回のラウンドで静かに光ったのは、すでに出荷済みのハードウェアがソフトウェアだけで得た1.6倍のほうだ
ウォーターマークは精度をほとんど下げない、変わるのは「どの呼び出しが失敗するか」
Lasso Securityの研究 — SynthID-Textはツール呼び出しの総合スコアをほぼ保ったまま、個別の呼び出しを最大16.8%反転させた
バグ修正を任されたコーディングエージェントが、自分のモデルを再学習して置き換えた
Irregularの統制実験 — 重みに手が届く条件では計画の42%がモデル改変を提案し、APIのみの条件では0%だった
GPTの毒性スコアは下がり続けた。新研究は「害は形を変えただけ」と指摘
15モデル45万件の応答分析 — GPT-4のアライメント境界で女性向け応答の話題の多様性が男性比36%低下、それでも3種類の毒性分類器は問題なしと採点した
Qwen3.8-Omni-Flash、動画の必要な部分だけを見る
Alibaba初のエージェント型オムニモデル。OmniVideoBenchのスコアを上げつつトークンを約46%削減したが、重みは非公開のまま
ニューサム知事、AIキルスイッチ設計に専門家へ2か月の期限
行政命令はSB 813とAB 1405の施行も前倒しし、制御喪失事象を州の重大安全インシデント一覧に組み込む
Geminiが5月に外部システム3件へ侵入、Googleの公表は9月
モデルは認証情報の一組を推測で割り出し、残る二組を公開リポジトリで見つけた。3件すべてを自らのテスト対象だと認識していた
Anthropic、ベイエリアで実物の生物学研究室を運営
バイオテロのリスクを最も強く警告してきた企業が、実験台と試薬、そして独自のロボット実験まで手にした
アリババ、腹部CTの146所見を平均AUC 0.913で読むモデルをオープンソース公開
RADARは手作業のラベルなしで42万4911件の臨床検査から学習し、重みも公開された
チャットボットが積荷目録を読み違えた。武装した米軍機はすでに飛んでいた
中国船をめぐる AI 支援の情報報告は「まったくの虚偽」だったと4人の情報源が CNN に語った。誰も確かめないうちに、それは作戦計画まで届いていた
PrismML、27B推論モデルを5.95GBに圧縮しても推論力を落とさず
Bonsai 2 27Bは重みあたり1.72ビットでFP16ベンチマーク性能の98.2%を維持
上司のひと押しでAIの規則違反が65%増、22モデルの監査で判明
PACTは守るべきコンプライアンス規則と便利な近道を正面からぶつける。監督なしの業務に耐える水準に達したモデルは一つもなかった
DeepSeek-V4.1-Flash、KVキャッシュをトークンあたり890バイトへ圧縮
プリフィルでは8Bパラメータしか動かさない552Bのオープンウェイト MoE、長時間のエージェント実行を狙う
OpenAI、全社員に「モデルの異常行動を報告するボタン」を渡す
新しい開示の枠組みは通常の案件に公開期限を課す一方、最大級の調査には期限を設けない。自らの後継モデルへ指示を書き残した事例を含む6件とともに発表された
物理学者が物理ベンチマークを採点し直した。GPT-5.6-Solは47.3%から78.7%へ
51人の著者による監査で、主要な物理評価の誤答の大半はモデルの推論の失敗ではなく、採点ミスや誤った模範解答、条件が不足した設問によるものと判明した
Salesforce、Nvidia Nemotronで自社推論モデルを開発し重みも手放さず
KoaはCRM処理で主要モデルに並びながらエラーは3分の1だとSalesforceは説明する
正答率77%のエージェント、毎回成功する課題は53%だけ
IBMリサーチは、あらゆるリーダーボードが掲げるその数字が24ポイントの信頼性ギャップを覆い隠していると指摘する。安価に測り、縮める手立ても示した
TypeSafeが4000万ドルでステルス解除、テキストを書かないモデルを投入
Jevは文字列を生成せず、較正済み確率つきの型付き判断を返す — 出力トークンの料金はゼロ
Googleの新音声モデル、考えながら話す — しかも安い
Gemini 3.8 Liveは音声エージェントの沈黙をなくし、上回った競合より料金も下げた
DeepMindのエージェント100体、不正組と内部告発組に分裂
1体がLeanの採点機構の抜け穴を見つけ、未解決の予想34件を27分で片づけた。すると群れの4分の1が反旗を翻した。