프랑스 파리의 비영리 AI 연구소 Kyutai가 Inria, 국립퐁제쇼세학교(École des Ponts)와 함께 공개 데이터만으로 사전학습한 24억(2.4B) 파라미터 로봇 조작 모델 REKI를 공개했다. 연구진은 10월 15일 arXiv에 논문을 올렸고, 코드와 체크포인트 6종을 GitHub·Hugging Face에 함께 내놓았다.
핵심 정리
- REKI는 Qwen3.5-2B 기반 시각언어모델에 2억 파라미터 행동 생성기를 붙인 2.4B 규모 VLA(시각·언어·행동) 모델이다.
- 프레임마다 레지스터 토큰 32개로 최근 3프레임을 기억해, RoboTwin Clean 과제에서 로봇 팔이 같은 동작을 오가는 비율을 18.6%에서 4.1%로 낮췄다.
- LIBERO-Plus 벤치마크에서 90.4%로 비교 모델 가운데 가장 높았지만, 가중치는 CC BY-NC-SA 4.0이라 상업적 이용은 막혀 있다.
Kyutai REKI는 어떤 로봇 모델인가
REKI는 카메라 영상과 언어 지시를 받아 로봇 팔의 움직임을 출력하는 VLA 모델이다. 알리바바 큐원의 Qwen3.5-2B를 시각언어 백본으로 쓰고, 그 뒤에 플로 매칭 방식의 2억 파라미터 행동 전문가(action expert)를 붙였다. 이름은 'Registering Knowledge in VLAs'의 약자다.
Kyutai가 공식 프로젝트 페이지에서 밝힌 학습 데이터는 모두 공개 자료다. 공개된 로봇 원격조작·시뮬레이션 데이터, EgoDex 등 사람 손 시점 영상 약 35만 에피소드, 시각언어 데이터를 섞었다. 모델 카드 기준 로봇·사람 손 프레임은 약 10억 장, 시각언어 샘플은 1,220만 건이며, H100 GPU 32장으로 20만 스텝을 사전학습했다.
레지스터 메모리가 로봇 팔 흔들림을 줄이는 방식
REKI의 기억 장치는 프레임마다 학습된 레지스터 토큰 32개를 두고, 그 키·값을 최근 3프레임(1초 간격)만큼 캐시에 보관하는 구조다. 과거 프레임 하나에 드는 GPU 메모리는 약 2MiB, 캐시를 읽는 데 더해지는 지연은 0.1ms다. 현재 화면만 보는 모델은 같은 위치를 왔다 갔다 하는 진동에 빠지기 쉬운데, 이 방식으로 RoboTwin Clean의 진동 에피소드 비율이 18.6%에서 4.1%로 줄었다.
속도도 가볍다. 연구진 측정으로 H100 한 장에서 행동 묶음 하나를 예측하는 데 21.8ms가 걸렸다. 같은 조건에서 π0.5(openpi 구현)는 33.8ms, X-VLA는 25.5ms였다.
REKI 벤치마크 성능은 경쟁 모델과 어떻게 다른가
프로젝트 페이지에 공개된 성공률은 아래와 같다. 연구진은 RoboTwin과 RoboCasa365에서 REKI를 앞선 모델이 대체로 크기가 두 배쯤 된다고 설명했다.
| 벤치마크(성공률 %) | REKI | π0.5 | 최고 비교 모델 |
|---|---|---|---|
| LIBERO-Plus | 90.4 | 85.7 | Qwen-RobotManip 89.0 |
| RoboTwin Clean2Rand | 65.8 | 63.8 | Qwen-RobotManip 68.5 |
| RoboCasa365 | 38.4 | 16.9 | Xiaomi-Robotics-1 57.4 |
공개 데이터 사전학습의 효과도 수치로 제시했다. 사전학습을 거치면 LIBERO-Plus 점수가 86.1%에서 90.4%로, RoboTwin Clean2Rand는 52.0%에서 65.8%로 올랐다.
개발자가 바로 쓸 수 있는 범위
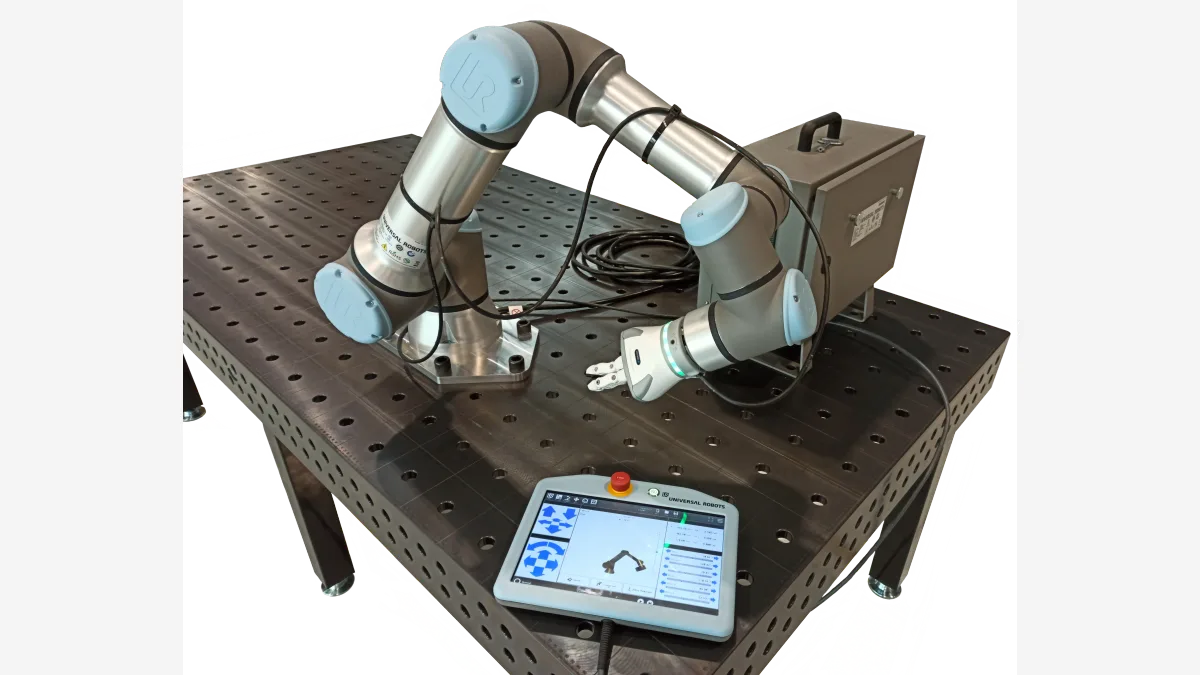
Hugging Face에는 사전학습본 reki-2b와 LIBERO·RoboTwin·RoboCasa용 파인튜닝 체크포인트 등 6종이 올라왔다. 모델 카드에 따르면 코드는 MIT, 가중치는 CC BY-NC-SA 4.0 라이선스다. 연구·실험 용도로는 자유롭게 쓸 수 있지만 상업 제품에 넣는 것은 허용되지 않는다. 실제 UR5 로봇 팔 시연에서는 과제당 시연 50개로 약 1시간(3천 스텝) 파인튜닝했다.
공개 데이터만 쓴 로봇 모델이 갖는 의미
로봇 기반 모델 경쟁은 그동안 자체 수집한 대규모 비공개 데이터를 가진 기업이 주도해 왔다. REKI는 누구나 내려받을 수 있는 데이터만으로 비슷한 체급 이상의 성적을 냈다는 점에서 학계의 재현 가능성을 넓힌다. 작은 연구 조직이 학습 과정까지 공개해 대형 모델과 겨루는 흐름은 Ai2의 8B 오픈소스 리서치 모델 사례와도 닮았다.
전망
한계도 분명하다. 모델 카드는 학습 시연 데이터가 주로 집게형 그리퍼의 탁상 조작이라 다른 손이나 과제에는 추가 파인튜닝이 필요하다고 적었다. 실제 로봇 성공률 수치도 아직 공개되지 않았다. 다른 연구실이 공개 체크포인트로 실제 로봇 결과를 재현하는지가 REKI의 실질적 평가 기준이 될 전망이다.
자주 묻는 질문
Kyutai REKI는 상업적으로 쓸 수 있나?
Hugging Face 모델 카드 기준 REKI 가중치는 CC BY-NC-SA 4.0 라이선스로, 비상업적 이용만 허용된다. 코드는 MIT 라이선스로 공개됐다.
REKI를 돌리려면 어떤 GPU가 필요한가?
REKI는 2.4B 파라미터 모델로, 연구진은 H100 한 장에서 행동 묶음 하나를 21.8ms에 예측했다고 밝혔다. 기억 기능은 과거 프레임당 약 2MiB의 GPU 메모리만 더 쓴다.
VLA 모델이란 무엇인가?
VLA(Vision-Language-Action) 모델은 카메라 영상과 자연어 지시를 함께 받아 로봇의 관절·그리퍼 동작을 직접 출력하는 모델이다. 시각언어모델의 이해 능력을 로봇 제어로 확장한 구조다.