
AWS 세이지메이커, GPU 한 장을 최대 7개로 쪼갠다
AWS가 11월 6일 세이지메이커 AI 추론에 엔비디아 MIG 기반 GPU 분할을 추가했다. GPU 한 장을 최대 7개 격리 조각으로 나눌 수 있고, AWS 시험에서 H100 절반 조각이 A100 한 장보다 빠르고 고부하 시 토큰당 비용이 18~34% 낮았다.
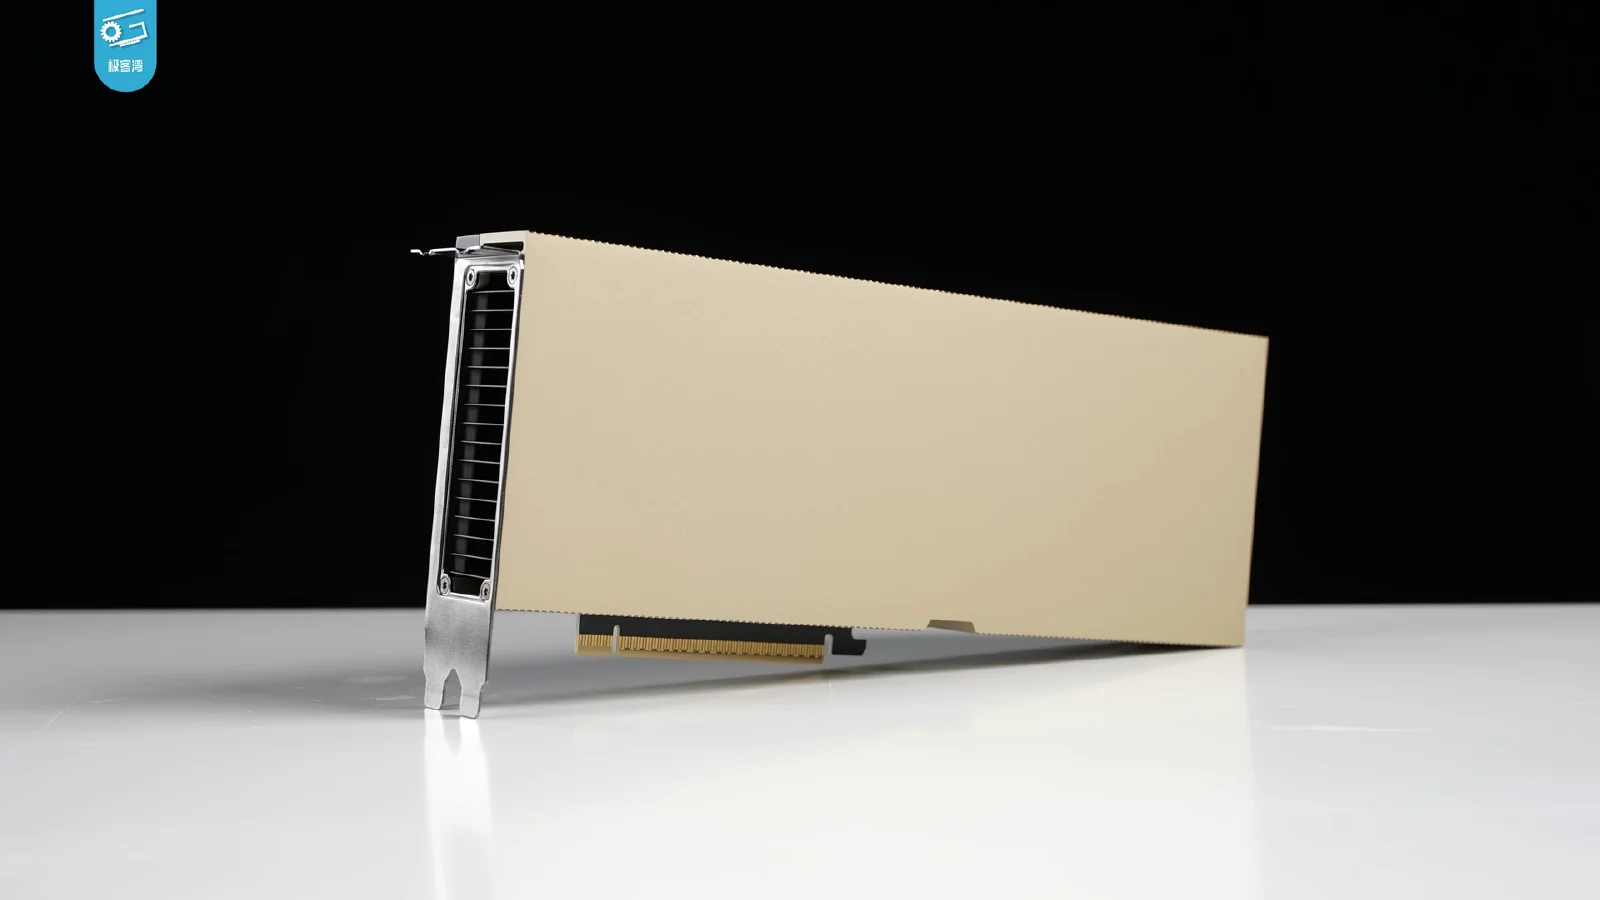
아마존웹서비스(AWS)가 11월 6일(현지시간) 머신러닝 추론 서비스 '아마존 세이지메이커 AI(Amazon SageMaker AI)'에 GPU 분할 기능을 추가했다. 엔비디아 GPU 한 장을 하드웨어로 격리된 최대 7개 조각으로 나눠 조각마다 다른 AI 모델을 올릴 수 있다. AWS는 공식 머신러닝 블로그에서 쿠버네티스를 직접 운영하지 않고도 엔비디아 멀티인스턴스 GPU(MIG)를 쓸 수 있게 됐다고 밝혔다.
핵심 정리
- 세이지메이커 엔드포인트에서 GPU 한 장을 연산·메모리가 분리된 MIG 조각 최대 7개로 나눌 수 있다.
- AWS 자체 시험에서 H100 절반 조각이 A100-40GB 한 장보다 처리량이 많았고, 부하가 높을 때 출력 토큰 100만 개당 비용이 18~34% 낮았다.
- 요금은 지금처럼 인스턴스 전체에 매겨진다.
세이지메이커 GPU 분할, 어떻게 쓰나
지금까지 세이지메이커 엔드포인트의 최소 단위는 GPU 한 장이었다. A100 8장짜리 ml.p4d.24xlarge에는 모델이 14GB만 써도 8개까지만 올릴 수 있었다.
새 기능은 기존 API에 선택 항목 두 개만 더한다. 엔드포인트 설정의 AcceleratorPartitionLayouts로 GPU를 어떻게 나눌지 정하고, 추론 컴포넌트의 AcceleratorPartitionType으로 모델이 돌아갈 조각을 고른다. 새 API나 IAM 권한은 필요 없고 호출 방식도 그대로다.
AWS 예시에서는 p4d의 A100을 각각 4g·2g·1g로 나눠 장비 한 대에서 24개 조각을 만들었다.
지원 인스턴스와 리전
대상은 P4d(엔비디아 A100 40GB, 최대 7조각), P5(H100 80GB, 7조각), G7(RTX PRO 4500 블랙웰 32GB, 2조각), G7e(RTX PRO 6000 블랙웰 서버 에디션 96GB, 4조각) 등 4개 인스턴스 계열이다. 미국 동부(버지니아 북부)·미국 서부(오리건)·아시아태평양(도쿄)·유럽(프랑크푸르트) 등 7개 리전에서 제공되며, 서울 리전은 목록에 없다.
요구 사항 설계와 초기 검증에는 세일즈포스가 참여했다. 리처드 창 세일즈포스 소프트웨어 엔지니어링 아키텍트는 AWS 글에서 "많은 추론 작업은 GPU 한 장 전체가 필요하지 않다"고 말했다.
H100 조각 대 A100 한 장, 성능 비교
AWS는 H100의 mig-3g.40gb 조각과 A100-40GB 한 장에 Llama-3.1-8B-Instruct를 올려 트래픽 유형 5가지, 동시 요청 2~512개 조건에서 비교했다. 조각은 시나리오별 비용 이점이 가장 큰 지점에서 초당 출력 토큰이 53~89% 많았다. 첫 토큰까지 걸린 시간은 5.6~47.5%, 토큰 사이 지연은 8.9~42.1% 짧았다.
비용 이점은 100토큰 프롬프트에서 동시 요청 64개, 8,000토큰에서 4개를 넘어야 나타났고, 그 아래에서는 A100이 더 쌌다. 6,000·8,000토큰 작업의 최고 부하에서 A100은 요청의 3분의 1에서 절반을 처리하지 못했지만 조각은 실패가 없었다. 비용은 오리건 리전 온디맨드 가격(ml.p4d.24xlarge 시간당 약 25.25달러, ml.p5.48xlarge 약 63.30달러) 기준이며, AWS 자체 시험 결과다.
알아둘 제약
분할 구성은 엔드포인트 생성 때 고정돼 바꾸려면 새 엔드포인트로 트래픽을 옮겨야 한다. 단일 모델·서버리스 엔드포인트, 이기종 인스턴스 풀, 비동기 추론은 지원하지 않는다. 세이지메이커 개발자 안내서에 따르면 분할 엔드포인트는 클라우드워치에 GPU·CPU·메모리 사용률 지표를 보내지 않는다. 격리는 GPU에만 해당한다.
전망
AWS는 이번 변화로 모든 GPU가 "한 가지가 아닌 여러 크기"가 됐다고 설명했다. 미세조정 모델, 임베딩·리랭커, 안전 분류기처럼 작은 모델을 꾸준히 운영하는 팀에 맞다. 모델 구성을 자주 바꾸거나 GPU가 여러 장 필요한 모델에는 이점이 적다.
자주 묻는 질문
GPU를 나누면 요금이 내려가나?
직접 내려가지는 않는다. 같은 장비에 모델을 더 올리거나 최신 GPU 일부만 써서 비용을 아끼는 방식이다.
운영 중인 엔드포인트의 분할 크기를 바꿀 수 있나?
없다. 다른 구성으로 업데이트하면 400 오류가 나므로 새 엔드포인트를 만들어야 한다.
참고 자료
- SageMaker Inference now supports Multi-Instance GPU to maximize GPU utilization for model endpoints — AWS 머신러닝 블로그(2026년 11월 6일)
- Using GPU partitions on SageMaker AI real-time endpoints — 아마존 세이지메이커 AI 개발자 안내서

댓글 0
현재 댓글 작성이 비활성화되어 있습니다.