
AWSのSageMaker、GPU1基を最大7区画に分割可能に
AWSは11月6日、SageMaker AIの推論にエヌビディアMIGによるGPU分割を追加した。GPU1基を最大7つの分離区画に分けられる。AWSのテストではH100の半分の区画がA100 1基より速く、高負荷時のトークン当たりコストが18〜34%低かった。
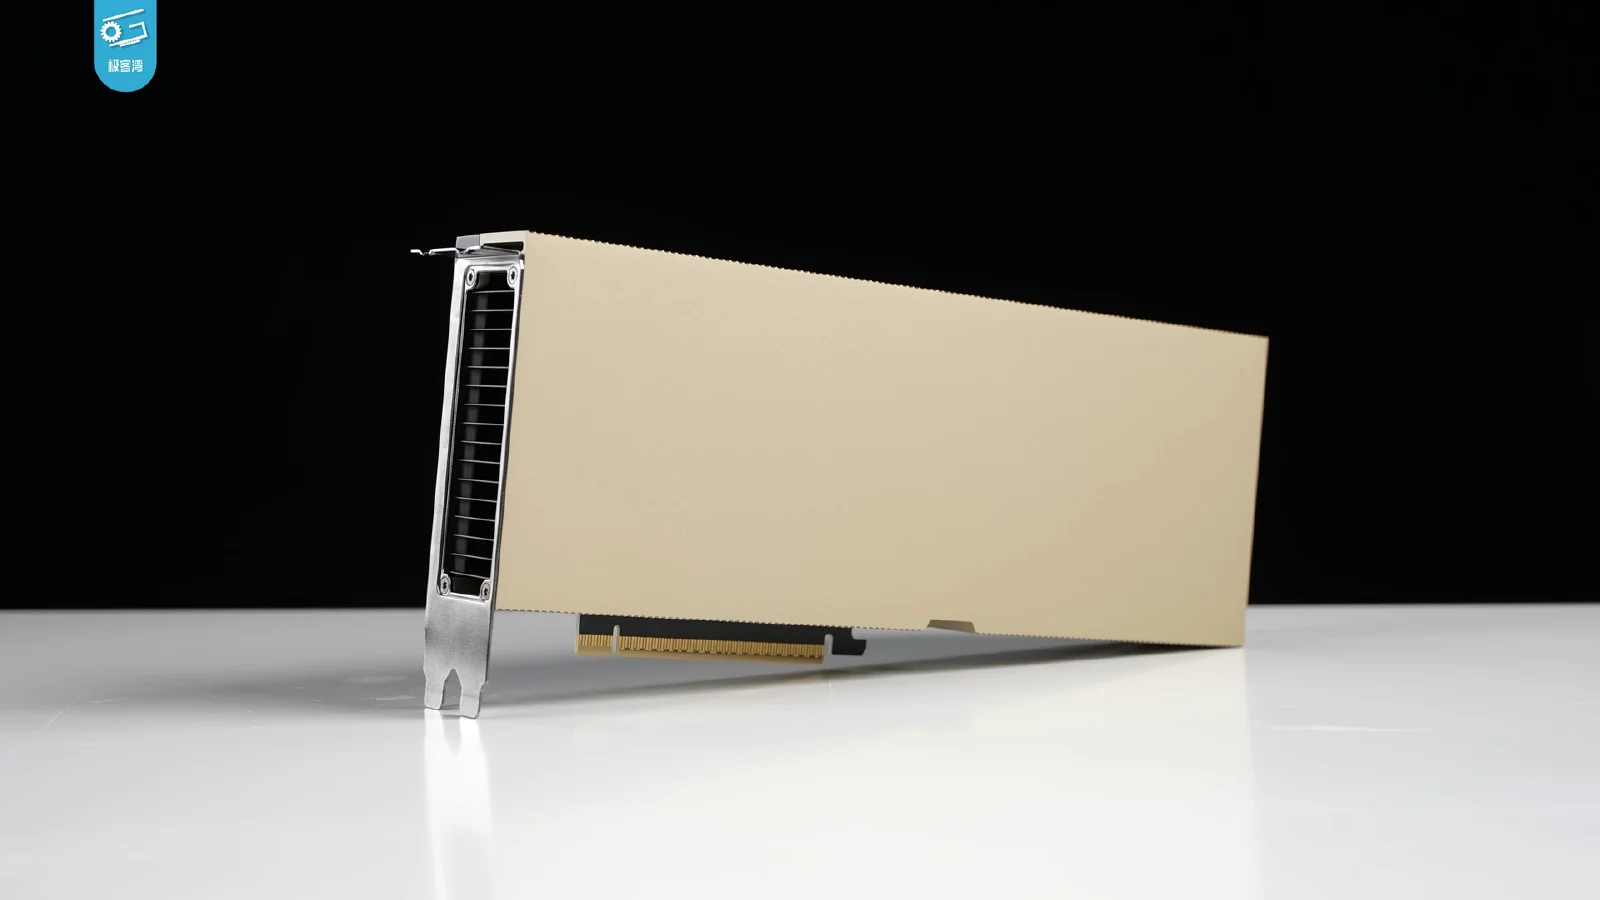
アマゾン・ウェブ・サービス(AWS)は2026年11月6日(米国時間)、機械学習の推論サービス「Amazon SageMaker AI」にGPU分割機能を追加した。エヌビディア製GPU1基をハードウェアで分離された最大7つの区画に分け、区画ごとに別のAIモデルを動かせる。AWSは公式の機械学習ブログで、Kubernetesを自前で運用せずにエヌビディアのマルチインスタンスGPU(MIG)を使えるようになったと説明している。
要点
- SageMakerのエンドポイントで、GPU1基を演算とメモリが独立したMIG区画に最大7つまで分けられる。
- AWSの社内テストでは、H100の半分の区画がA100-40GB1基を処理量で上回り、高負荷時には出力100万トークン当たりのコストが18〜34%低かった。
- 料金はこれまで通りインスタンス全体に課金される。
SageMakerのGPU分割の仕組み
これまでSageMakerのエンドポイントが確保できる最小単位はGPU1基だった。A100を8基積むml.p4d.24xlargeでは、モデルが14GBしか使わなくても載せられるのは8つまでだった。
新機能は既存のAPIに任意項目を2つ加えるだけである。エンドポイント設定のAcceleratorPartitionLayoutsでGPUの分け方を決め、推論コンポーネントのAcceleratorPartitionTypeでモデルを載せる区画を選ぶ。新たなAPI操作やIAM権限は不要で、呼び出し方も変わらない。
AWSの例では、p4dのA100をそれぞれ4g・2g・1gの3区画に分け、1台で24区画を用意した。分割によるエンドポイント準備時間の増加は約17秒だったという。
対応インスタンスとリージョン
対象はP4d(A100 40GB、最大7区画)、P5(H100 80GB、7区画)、G7(RTX PRO 4500 Blackwell 32GB、2区画)、G7e(RTX PRO 6000 Blackwell Server Edition 96GB、4区画)の4系統だ。提供リージョンは米国東部(バージニア北部)、米国西部(オレゴン)、アジアパシフィック(東京)、欧州(フランクフルト)など7つで、東京リージョンでも使える。
要件の策定と初期検証にはセールスフォースが加わった。同社のソフトウェアエンジニアリングアーキテクト、リチャード・チャン氏はAWSのブログで「多くの推論ワークロードはGPU1基をまるごと必要としない」と述べている。
H100の区画とA100 1基の性能比較
AWSはH100のmig-3g.40gb区画1つとA100-40GB 1基にLlama-3.1-8B-Instructを載せ、5種類のトラフィック形態、同時リクエスト2〜512の条件で比べた。区画はシナリオごとにコスト優位が最も大きい負荷点で、毎秒の出力トークン数が53〜89%多かった。最初のトークンまでの時間は5.6〜47.5%、トークン間の遅延は8.9〜42.1%短縮した。
コスト優位が出るのは、100トークンのプロンプトで同時リクエスト64、8000トークンで4を超えてからで、それ以下ではA100 1基の方が安かった。6000・8000トークンの処理では、最大負荷時にA100がリクエストの3分の1から半分をさばけなかったのに対し、区画の失敗はゼロだった。コストはオレゴンのオンデマンド価格(ml.p4d.24xlargeが1時間約25.25ドル、ml.p5.48xlargeが約63.30ドル)に基づく。いずれもAWS自身による測定である。
導入前に知っておきたい制約
分割の構成はエンドポイント作成時に固定され、変更するには新しいエンドポイントを作ってトラフィックを移す必要がある。単一モデル・サーバーレスのエンドポイント、異種インスタンスプール、非同期推論には対応しない。SageMaker開発者ガイドによると、分割したエンドポイントはCloudWatchにGPU・CPU・メモリの使用率を出さない。分離されるのはGPUだけで、ホストのCPUやメモリ、ストレージ、ネットワークは共有となる。
今後の見通し
AWSは今回の変更で、どのGPUも「1種類ではなく複数のサイズ」になったと位置づける。微調整モデルや埋め込み・リランカー、安全性分類器など、小〜中規模のモデルを安定して動かすチームに向く。モデル構成を頻繁に入れ替える場合や、1モデルに複数のGPUが要る場合の恩恵は小さい。AWSは試用向けのサンプルノートブックをGitHubで公開した。
よくある質問
GPUを分割すると料金は下がるのか。
直接は下がらない。課金はインスタンス全体が対象で、同じ設備により多くのモデルを載せたり、新しいGPUの一部だけを使ったりしてコストを抑える仕組みだ。
稼働中のエンドポイントで区画サイズを変えられるか。
できない。別の構成で更新すると400エラーになるため、新しいエンドポイントを作る必要がある。
参考資料
- SageMaker Inference now supports Multi-Instance GPU to maximize GPU utilization for model endpoints — AWS Machine Learning Blog(2026年11月6日)
- Using GPU partitions on SageMaker AI real-time endpoints — Amazon SageMaker AI開発者ガイド

コメント 0
現在コメントの投稿は無効になっています。