
르쿤, AI '플라톤적 표현 가설' 정리로 증명
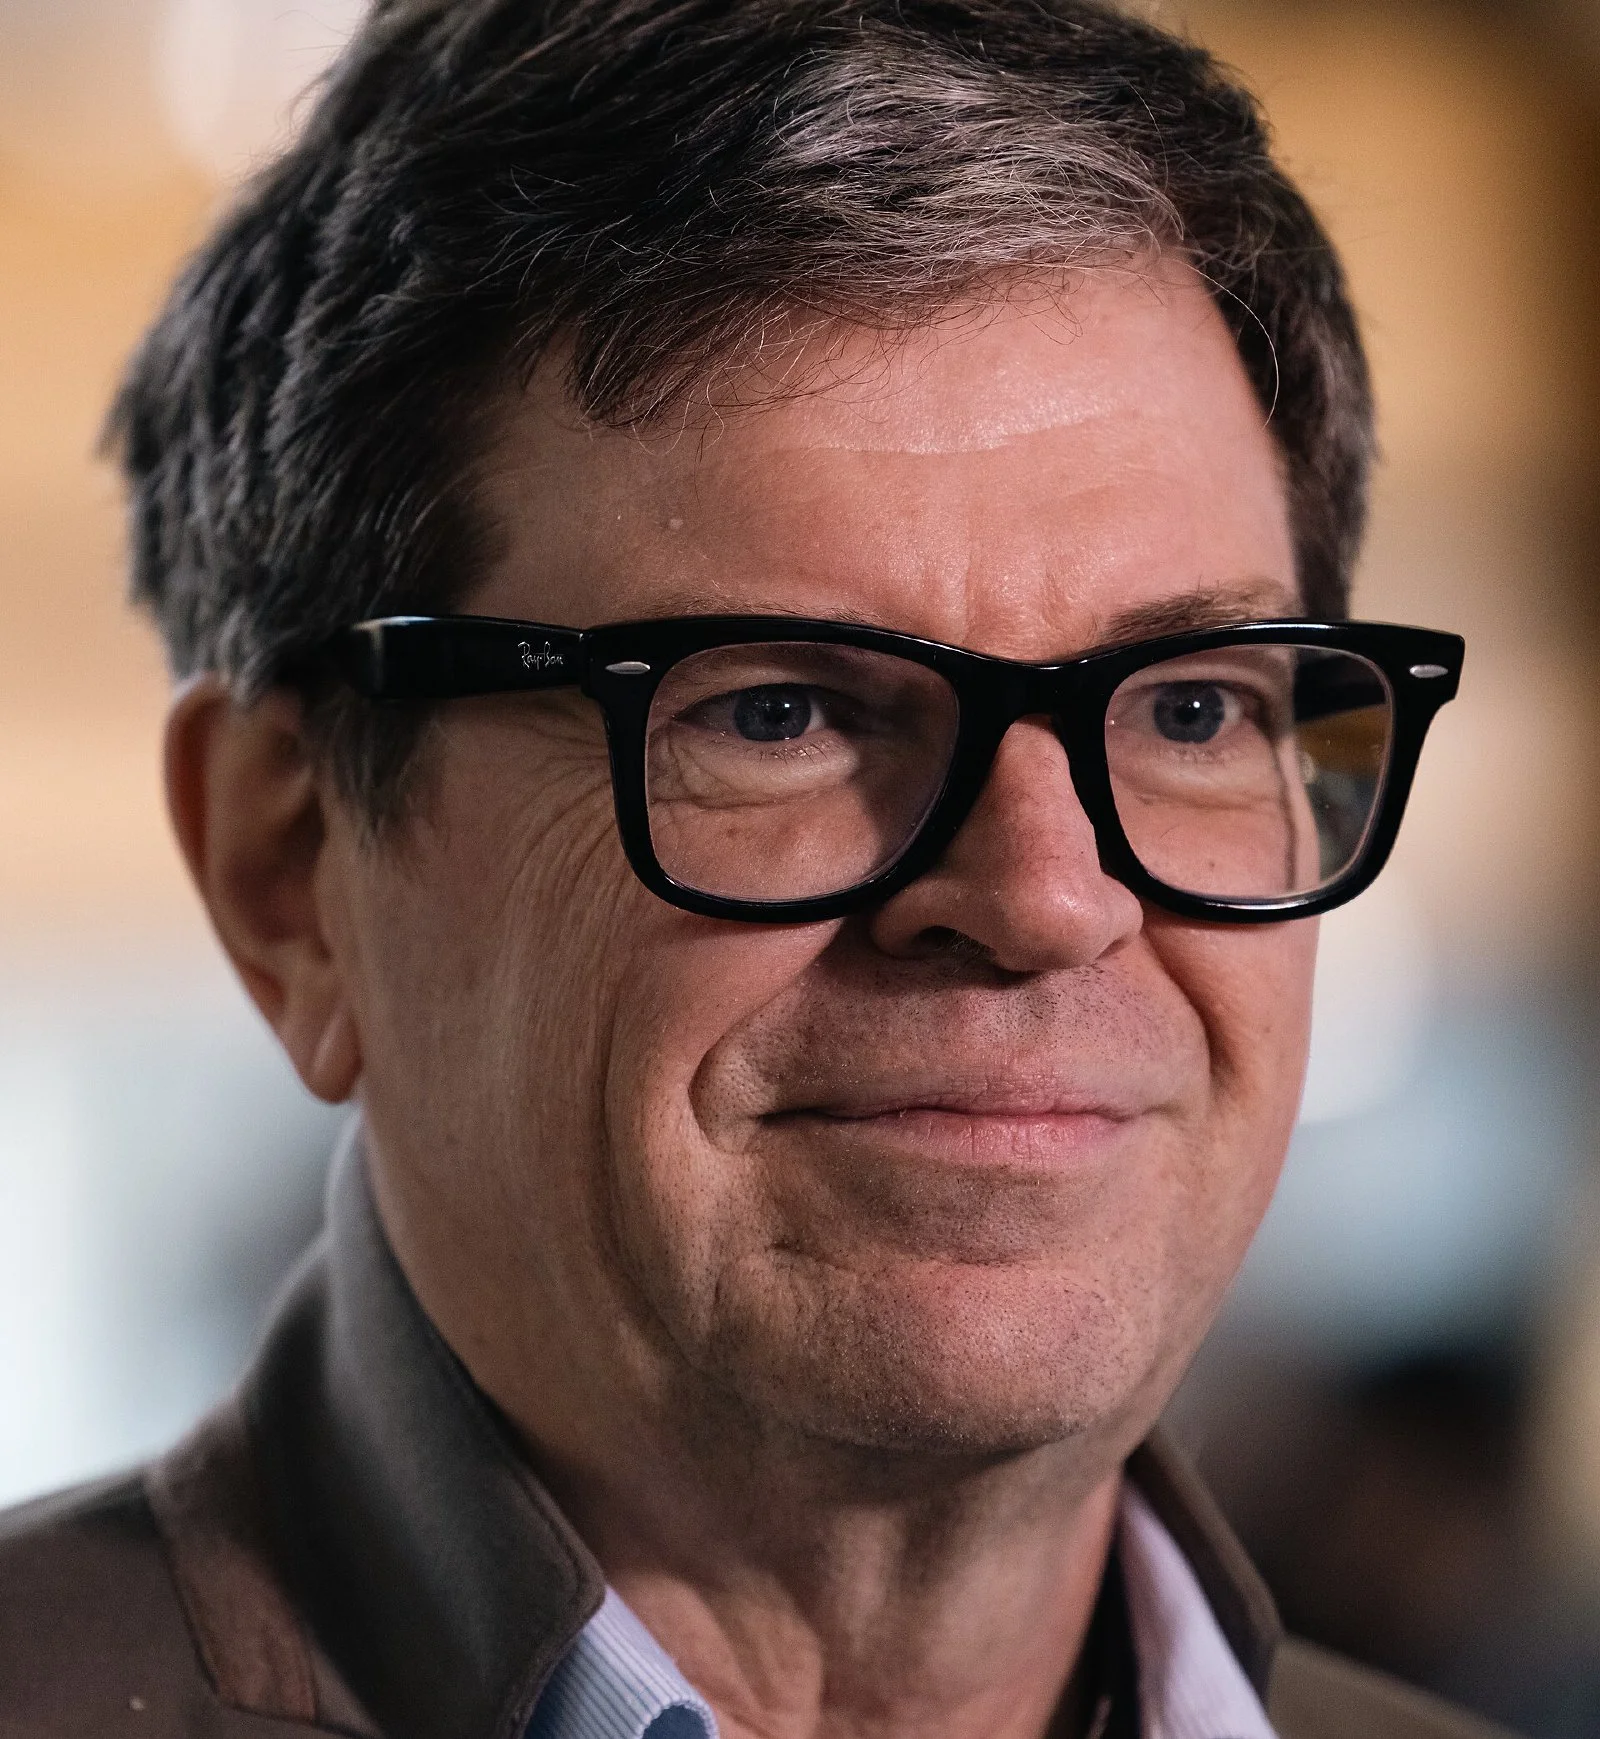
얀 르쿤과 랜들 발레스트리에로가 10월 29일 아카이브에 JEPA로 '플라톤적 표현 가설'을 증명했다는 논문을 올렸다. 1억900만 매개변수 텍스트 JEPA가 최대 720억 언어모델보다 시각 인코더와 잘 정렬됐고, 다음 토큰 예측보다 샘플이 42분의 1이면 됐다.
얀 르쿤(뉴욕대)과 랜들 발레스트리에로(브라운대)가 10월 29일 논문 공개 사이트 아카이브(arXiv)에 서로 다른 데이터로 학습한 AI 모델이 결국 같은 세계 표현으로 수렴한다는 '플라톤적 표현 가설'을 정리(定理)로 증명했다는 논문을 올렸다. 실험에서는 1억900만 매개변수 텍스트 모델이 최대 720억 매개변수 언어모델보다 시각 모델과 더 잘 맞아떨어졌다.
핵심 정리
- 서로 다른 모달리티로 따로 학습한 JEPA(결합 임베딩 예측 구조)는 같은 장면의 두 관점을 학습 쌍으로 쓰면 회전 하나만큼만 다른 동일한 표현을 학습한다는 것이 논문의 증명이다.
- 1억900만 매개변수 텍스트 JEPA가 DINOv2·CLIP 이미지 인코더와의 정렬에서 최대 720억 매개변수까지 시험한 모든 언어모델을 앞섰고, 다음 토큰 예측보다 학습 샘플이 42분의 1이면 충분했다.
- 이상화된 가정에 기댄 결과이며, 코드는 MIT 라이선스로 공개됐다.
플라톤적 표현 가설이란
이 가설은 2024년 MIT 연구진(민영 허, 브라이언 청, 퉁저우 왕, 필립 이솔라)이 제시했다. 학습 목표·데이터·모달리티가 달라도 신경망은 표현 공간에서 "현실에 대한 공유된 통계 모델로 수렴하고 있다"는 주장이다.
발레스트리에로는 X에 "플라톤적 표현 가설은 이제 정리"라고 적어 이번 연구를 알렸다. 논문에 따르면 발레스트리에로는 브라운대와 AMI 랩스, 르쿤은 뉴욕대와 AMI 랩스 소속이다.
JEPA 증명의 원리
JEPA는 원본 픽셀이나 다음 단어 대신, 어떤 대상의 한 관점에서 다른 관점의 임베딩을 예측하며 배운다. 연구진은 학습 쌍이 같은 장면을 두 번 본 '좋은 관점'이면 따로 학습한 JEPA들의 표현이 회전 하나만큼만 차이 난다는 것을 보였다.
연구진은 다음 토큰 예측을 한 문서의 조각끼리 짝짓는 '나쁜 관점'의 JEPA로 해석했다. 대규모 언어모델이 주로 규모를 키워야 시각 모델과 정렬되는 이유가 여기에 있다는 설명이다.
1억900만 대 720억, 수치로 본 결과
연구진은 캡션 14만5000건부터 웹 이미지 9억4000만 장의 텍스트까지 여러 데이터로 이론을 검증했고, 정렬에 관한 스케일링 법칙도 제시했다. 깃허브 저장소에 따르면 좋은 관점은 다음 토큰 예측이 9억 개 샘플로 얻은 정렬을 2160만 개로 달성했다.
| 시험 | 결과 |
|---|---|
| DINOv2-B와의 정렬(WIT-1024) | 1억900만 텍스트 JEPA 0.184, 최고 언어모델 0.154 |
| 제로샷 ImageNet-100 top-5 | 텍스트 JEPA 64%, 80억 이하 언어모델 최대 56% |
| 회전 한 번으로 만든 캡션 생성기(CIDEr) | COCO 0.838, MSR-VTT 0.246 |
| 연산량 | 실험 345회, 약 5500 GPU시간 |
맥락과 한계
르쿤은 다음 토큰 예측만으로는 인간 수준 AI에 이를 수 없다고 오래 주장해 왔고, 그 대안으로 내세운 구조가 JEPA다. 이번 논문은 그 주장에 수학적 근거를 더하지만, 동료 심사를 거치지 않은 사전 공개 논문이다.
연구진도 한계를 적었다. 정리는 유한한 세계와 이상적 최적화를 가정하고, 항등 예측기를 쓰는 JEPA만 다루며, 관측 하나가 장면을 완전히 결정한다고 본다. 동영상 7000개로 학습한 연구진의 이미지 JEPA는 DINOv2보다 훨씬 약하다.
전망
연구진은 이미지 쪽 좋은 관점을 대규모로 늘리는 일을 후속 과제로 남겼다. prh-proof 저장소는 모든 그림·표를 해당 실험과 연결해 두어, 42배 효율이 더 큰 규모에서도 유지되는지 외부에서 검증할 수 있다.
자주 묻는 질문
작은 JEPA가 대형 언어모델보다 뛰어나다는 뜻인가?
시각 인코더와의 정렬, 관련 제로샷 시험이라는 좁은 기준에서만 그렇다. 논문은 1억900만 모델이 글쓰기·추론·코딩에서 720억 모델과 겨룬다고 주장하지 않는다.
동료 심사를 거친 결과인가?
아니다. 2026년 10월 29일 아카이브에 올라온 사전 공개 논문이며, 정리는 연구진이 밝힌 이상화된 가정에 기대고 있다.
참고 자료
- Proving and Improving the Platonic Representation Hypothesis with JEPAs — arXiv(2026년 10월 29일)
- galilai-group/prh-proof — GitHub
- The Platonic Representation Hypothesis — Huh 외, MIT(ICML 2024)

댓글 0
현재 댓글 작성이 비활성화되어 있습니다.