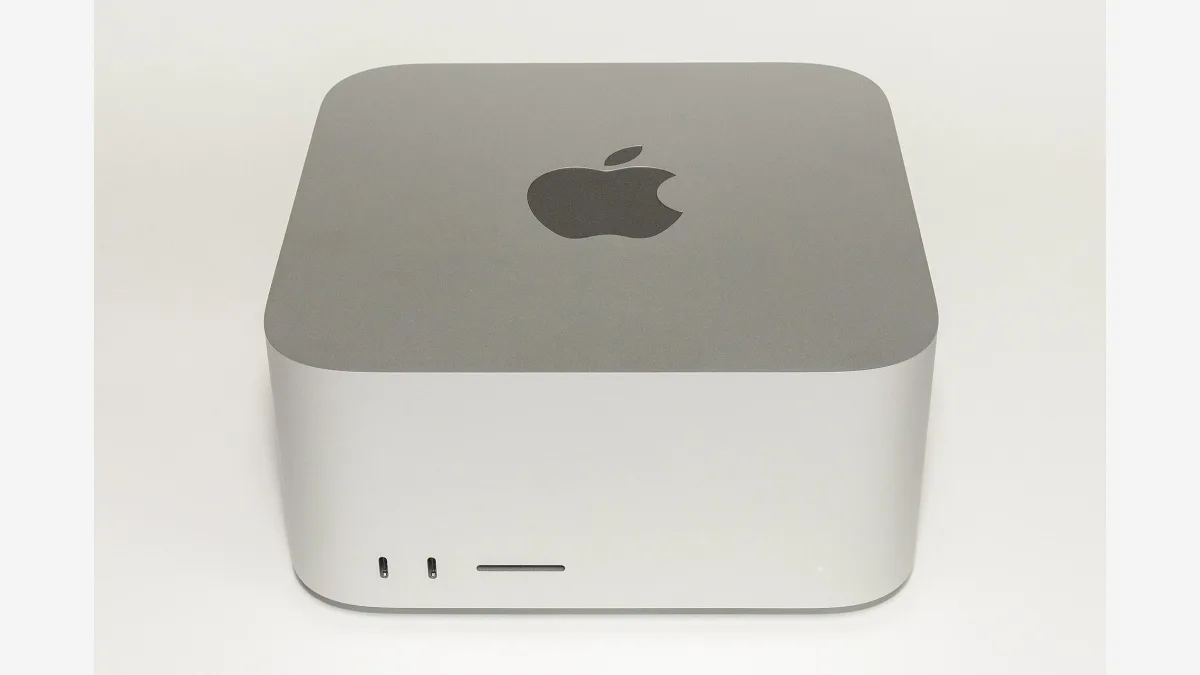
Redis 作者薩爾瓦多·桑菲利波以 C 語言撰寫的 MIT 授權推論引擎 DwarfStar 4(ds4)公布的參考基準,攤開了一道對任何要配置個人 AI 工作站的人都很關鍵的裂縫:兩台同為 128 GB 的機器,一台吃進提示的速度遠勝對手,另一台回吐 token 的速度卻是對方的兩倍有餘。
以 q2 精度、32,768 token 的上下文跑 DeepSeek V4 Flash,ds4 在配備 128 GB 統一記憶體的 M5 Max Mac 上每秒生成 34.4 個 token,而同樣 128 GB 的 NVIDIA DGX Spark 只有 14.4。預填階段的排名則倒轉過來:在同一上下文長度下,Spark 每秒吃進 855.9 個 token,Mac 僅達 557.0。把上下文拉到 65,536 token,Spark 幾乎不動,仍有 823.0,Mac 卻掉到 398.5。
重點摘要
- ds4 是桑菲利波打造的自成一體、採 MIT 授權的 C 推論引擎,瞄準的是一份很短的特定開放權重模型清單,而非扮演通用 GGUF 執行器。
- 在 DeepSeek V4 Flash q2、32,768 token 上下文下,公布的數據顯示 128 GB M5 Max 每秒生成 34.4 個 token,128 GB DGX Spark 為 14.4;預填則由 Spark 以 855.9 對 557.0 領先。
- 專案一併提供三支執行檔:一個 CLI、一個相容 OpenAI 與 Anthropic 介面的本機伺服器,以及一個直接在行程內跑推論、而非透過 socket 的程式開發代理。
ds4 刻意不想成為的東西
專案文件直言 ds4 不是通用的 GGUF 執行器。它只載入專案自己產出的 GGUF 檔案,而模型支援被描述為機會主義式的:一旦出現更好的替代品,舊模型就會被移除。引擎不連結 GGML,但在文件中記上 llama.cpp 的貢獻,並保留了從中沿用的 MIT 授權量化佈局、CPU 點積邏輯與部分核心。
目前支援的系列涵蓋 DeepSeek V4 Flash(含一個實驗性的視覺檢查點)、DeepSeek V4.1 Flash、DeepSeek V4 PRO、GLM 5.2 與 5.3、GLM 5.3 Flash 以及 Qwen3.8 Flash Next。在 Mac 上,主要目標是 96 GB 以上機型所用的 Metal。CUDA 方面以 DGX Spark 為核心,但也延伸到採用 L40S 等 Ada Lovelace 顯卡的多 GPU 機組;ROCm 則負責 Framework Desktop 這類 Strix Halo 系統。
把龐大的混合專家模型塞進一張書桌,靠的是非對稱量化:對被路由的專家大幅壓縮,對共用的關鍵路徑保留精度。Qwen3.8 較小的 Q2 版本,主權重加上多 token 預測權重共 41.73 GiB,專案把它定位為 64 GB Mac 的入門選項。
為什麼代理跑在引擎裡面
ds4-server 這支執行檔講的是 OpenAI 與 Anthropic 風格的 API,因此 Claude Code、Codex CLI 與 OpenCode 之類的工具只要把 base URL 指向本機即可。另一支獨立的 ds4-agent 則完全跳過這道邊界,直接在行程內驅動推論,於是整段開發工作階段本身就成了落在磁碟上的 KV 快取——長前綴會存進 SSD,重啟之後靠提示的雜湊值接續,而不必重新吃一遍。
那正是代理工作中昂貴的那一半。DeepSeek 也在從模型這一側拉同一根槓桿,V4.1 Flash 把 KV 快取壓到每個 token 僅 890 位元組。
保留條件都寫在明面上
桑菲利波把這套軟體稱為 beta 品質,說每次釋出前都會跑一輪大規模 QA,但退化仍有可能發生。他也揭露 ds4 是在 AI 程式開發代理的大力協助下完成的,構想、測試與除錯由人主導,並表示不能接受 AI 參與撰寫程式碼的讀者可以另尋他物。他把成果定位為一個可運作的範本,預期擁有者會用自己的代理繼續擴充,而不是一件完成品。
分散式的數字則澆熄了串接多台機器的衝動。兩台 M5 Max Mac 透過 Thunderbolt 5 連線跑 Flash Q4 時,預填能擴展,生成卻不行——它依然是自迴歸的,相較單機還要付出約 19% 的代價。另一組更密集的八張 L40S 配置,在 16 個並行工作階段下的生成總量約為每秒 126 個 token,這是多使用者伺服器的樣貌,不是單一對話變快了。
這些數字來自 ds4-bench,它會以 2,048 token 為步長把一段公有領域文本推到各個上下文邊界,再量測 128 個貪婪解碼 token,因此每一列都是該上下文長度下的吞吐量,而非整段執行的平均值。數據刊在專案的效能指南中,並同步到社群的 DwarfStar 基準表,該表目前正向 ROCm 與一般 CUDA 環境的使用者徵集自行測得的結果。
FAQ 常見問題
ds4 是開源的嗎?
是。ds4 以 MIT 授權釋出,它從 llama.cpp 改用的量化表與核心也適用同一份授權。原始碼放在 github.com/antirez/ds4,儲存庫同時附上專案的 GGUF、imatrix 以及品質與速度相關工具。
ds4 能跑任何 GGUF 模型檔嗎?
不能。這套引擎的範圍是刻意設窄的,只執行專案為支援系列自行建置的 GGUF 檔案。來自別處的通用 GGUF 檔明確不在目標之內,這是它為了能端到端驗證每一種支援佈局所做的取捨。
在 ds4 上跑 DeepSeek V4 Flash 需要多少記憶體?
Metal 瞄準的是 96 GB 以上的 Mac,參考數據則是在 128 GB 機器上測得。較小的系統可以退一步改用 SSD 串流,而 41.73 GiB 的 Qwen3.8 Q2 版本被定位為 64 GB Mac 的起點。