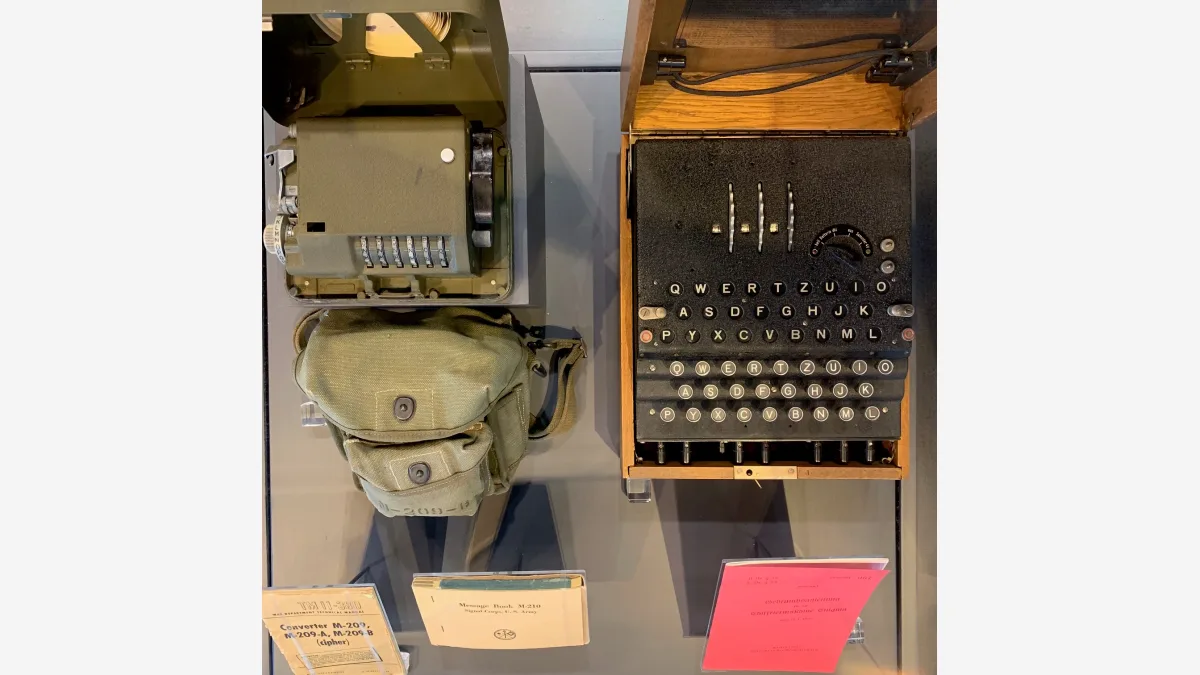
1941년 7월 10일 발신된 독일 육군 에니그마 암호 무전이 마침내 읽혔다. 암호해독가 Frode Weierud의 미해독 목록에 2005년부터 올라 있던 전문이고, 이를 푼 주체는 OpenAI의 GPT-6 Astra다. Crypto Cellar Research 아카이브를 운영하는 Weierud는 2026년 9월 15일 Bloomberg LP의 제품 개발 코치 Carter Leffen에게 연락을 받은 뒤 해독 결과를 검증했다.
전문은 82자이고 식별자 MVUEH로 구분한다. 전술 호출부호 2ny를 쓰는 기지국이 송신했고, 같은 날 17시 30분 SS-토텐코프 사단 병참감 무전소가 수신 전문 172호로 기록했다. 평문의 내용은 평범하다. 행군로를 지정해 달라는 요청, 발신자가 로제노프에 있다는 알림, 그리고 즉시 무전으로 회신하라는 요구가 전부다.
핵심 요약
- MVUEH는 휠 순서 253을 썼다. 1941년 7월 10일에 해독된 다른 전문은 모두 휠 순서 512였다.
- GPT-6 Astra는 에니그마 시뮬레이터와 소프트웨어 봄베를 직접 Python과 C++로 작성한 뒤, 반복 등장하는 지명 ROSENOW를 크립으로 삼아 해독을 실행했다.
- Weierud는 모델이 지시 없이 처음부터 끝까지 해냈다고 설명한 반면, Leffen 본인의 기록은 사람이 목표를 정하고 AI 에이전트가 근거 수집·탐색·검토를 맡았다고 서술한다.
MVUEH가 20년을 버틴 이유
1941년 7월 10일에 복원된 다른 전문은 모두 휠 순서 512로 같았다. MVUEH만 달랐다. 이 전문의 키는 휠 순서 253에 플러그 연결도, 링 설정도 달랐다. 2017년 Alex Shovkoplyas가 옆 전문인 173호, 식별자 SIPVX를 풀면서 그날 설정에서 벗어난 키가 이미 드러나 있었지만, 그 키를 MVUEH에 적용해도 아무것도 나오지 않았다.
나머지 장애물 둘은 해독 후에야 모습을 드러냈다. 원본 전문 용지에서 암호문을 옮겨 적는 과정에 오류가 여럿 있었고, 에니그마의 왼쪽 휠이 72번째 글자에서 넘어갔다. 드물게 일어나는 이 현상은 탐색을 크게 어렵게 만든다. Weierud는 이 두 가지가 앞선 시도들이 실패한 원인이라고 본다.
해독은 어떻게 이뤄졌나
에니그마의 하루 설정은 약 1.59 × 10²⁰가지에 이르러 무차별 대입은 애초에 선택지가 아니었다. 돌파구는 크립이었다. 이미 풀린 SIPVX 전문에 지명 로제노프가 연달아 두 번 등장했고, 같은 표현이 MVUEH에도 나올 것이라는 추정이 출발점이 됐다. 어떤 글자도 자기 자신으로 암호화하지 않는다는 이 기계의 결정적 약점이 대부분의 크립 정렬을 즉시 걸러냈다.
한 정렬 위치에서 모든 것이 들어맞았다. 복원한 설정은 나머지 문자를 앞뒤가 맞는 독일어로 풀어냈고, 여기에는 Angabe des Marschweges와 Sofort Funkantwort가 포함됐다. 따로 보존돼 있던 전문 헤더가 이 키를 확인해 줬다.
MVUEH의 평문은 SIPVX의 평문과 거의 같았다. 두 전문이 열두 글자 차이를 보이는 이유는 운용자가 MVUEH에서 Bitte를 Btte로 잘못 쳤고, SIPVX에는 서명 Waschbusch가 한 번 더 들어갔기 때문이다. Leffen은 이렇게 남은 오타 BTTE와 WASCHBBSCH를 해독이 진짜라는 증거로 본다. 지어낸 평문이라면 매끄럽게 읽혔을 것이라는 이유에서다.
얼마나 자율적이었나
두 설명이 갈리는 지점이 여기다. Weierud는 GPT-6 Astra가 전적으로 스스로 해냈다고 적었다. 미해독 목록에서 가장 유망한 표적으로 MVUEH를 직접 골랐고, SIPVX와의 연관성을 의심했으며, 다른 접근이 실패한 뒤 로제노프 크립에 도달했다는 것이다. The Decoder가 정리한 Leffen 본인의 기록은 훨씬 절제돼 있다. 목표를 세우고 판단을 내린 것은 자신이며, 전문화된 에이전트들이 근거 수집과 탐색, 교차 확인을 맡았다는 설명이다.
투입 규모에 대해서는 두 설명이 일치한다. "Extra High" 변형을 써서 모델이 이 문제에 쓴 시간은 대략 열 시간이다. 모델이 나중에 인용한 연방문서보관소 소장 자료를 몇 주에 걸쳐 조사한 Weierud는, 모델이 이틀 만에 해낸 일을 사람이 하려면 몇 주에서 몇 달이 걸린다고 말한다. Leffen은 해독 자체보다 결과를 설명하는 웹사이트에 아흔아홉 배의 품이 들었다고 밝혔다.
다음 과제
Weierud는 아직 모델의 로그를 읽는 중인데, 이미 눈에 띄는 항목이 하나 있다. GPT-6 Astra가 연방문서보관소 자료 번호 RS 3-3/20a와 RS 3-3/63b를 인용했는데, 둘 다 정확한 번호이면서도 Crypto Cellar 사이트 어디에도 나오지 않는다. 모델이 이를 어디서 얻었는지는 분명하지 않다. 공개된 패키지는 키 탐색을 재현하고 계산을 검증하지만, 이 해답이 유일하다거나 역사적 귀속이 확실하다는 것까지 입증하지는 못한다. 독립적인 검토는 여전히 남아 있다. 이번 결과는 열린 과제에 대한 이 모델의 도달 범위를 두고 나온 다른 주장들과 같은 주에 나왔는데, 여기에는 컴퓨터 사용 능력을 앞세운 OpenAI의 Astra 판매 전략도 포함된다.
FAQ — 자주 묻는 질문
GPT-6 Astra가 에니그마를 처음 뚫은 것인가?
아니다. 에니그마는 1932년 폴란드 수학자 Marian Rejewski가 처음 해독했고, 일반적인 해법은 수십 년째 공개돼 있다. 이번에 새로운 것은 2005년 이후 모든 시도를 물리쳤던 특정 전문 하나의 키를 복원했다는 점이다.
결과를 독립적으로 확인할 수 있나?
부분적으로 가능하다. Leffen이 코드와 탐색 데이터, 작동하는 에니그마 시뮬레이터를 공개했고, 이 패키지로 키 탐색을 재현하고 계산을 검증할 수 있다. 다만 이 평문이 유일한 해답이라거나 전문의 역사적 신원이 맞다는 것까지 증명하지는 못하므로, 완전한 검증은 다른 암호해독가들의 검토에 달려 있다.
해독된 전문 자체가 역사적으로 중요한가?
내용만 놓고 보면 그렇지 않다. 로제노프에 있던 발신자가 행군로를 묻는 일상적인 병참 문의다. 의미는 방법론에 있다. AI 시스템이 표적 선정부터 도구 제작, 검증까지 암호해독 작업 전 과정을 스스로 돌렸다는 사실을 보여준다.