
앤트로픽, AI 답변 낸 모델 증명하는 플래시프루브 공개
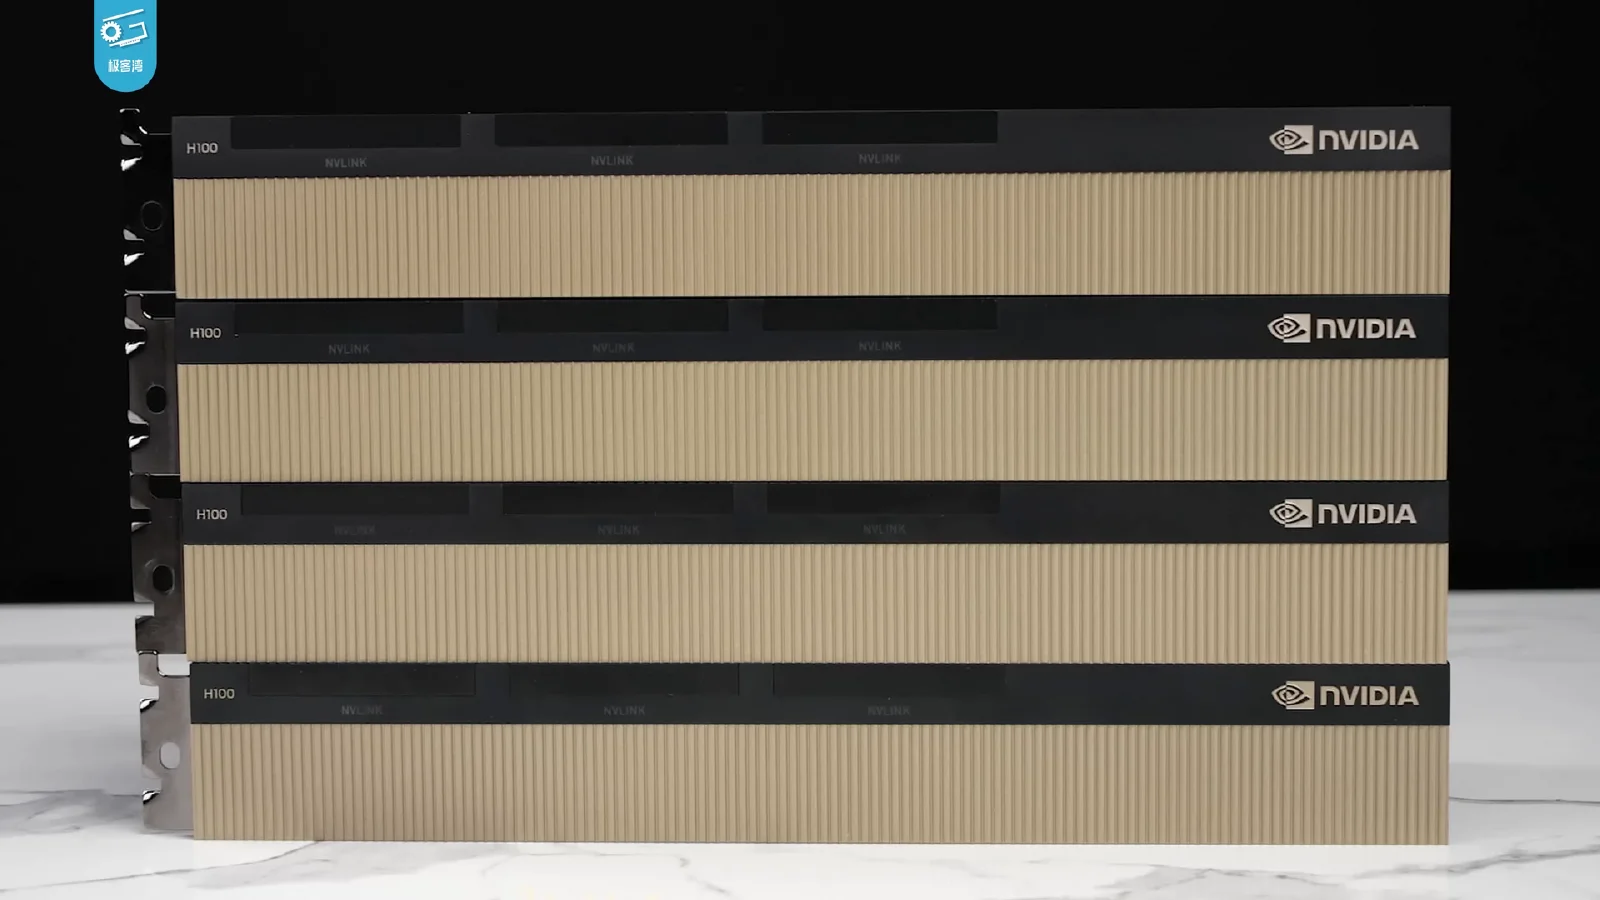
앤트로픽이 11월 2일 AI 응답이 약속한 모델에서 나왔음을 가중치 공개 없이 암호학적으로 증명하는 오픈소스 시제품 '플래시프루브'를 공개했다. H100 GPU 한 장으로 4,000억 파라미터 라마 4 매버릭의 출력을 초당 약 110토큰 증명한다.
앤트로픽이 11월 2일 AI 응답이 어떤 모델에서 나왔는지 가중치를 공개하지 않고도 암호학적으로 증명하는 오픈소스 연구 시제품 '플래시프루브(FlashProve)'를 내놨다. 엔비디아 H100 GPU 한 장으로 메타의 4,000억 파라미터 모델 라마 4 매버릭(Llama 4 Maverick)의 출력을 초당 약 110토큰 속도로 증명해, 앞서 공개된 오픈소스 시스템보다 크게 앞섰다.
핵심 정리
- 서비스 업체가 미리 약속(커밋)한 모델이 실제로 그 답을 냈는지 누구나 일반 CPU로 검증할 수 있다.
- H100 한 장에서 초당 약 110토큰을 증명하고, 1,024토큰 요청의 증명 파일은 약 19MB다. 다만 일반 추론보다 GPU 시간이 70~95배 든다.
- 앤트로픽은 '중간 성과'라고 선을 그었다. 그리디 디코딩, 정수화한 가중치, 1,024토큰 문맥에서만 작동한다.
'증명 가능한 추론'이란
AI 기업이 API로 모델을 제공하면 이용자는 광고한 모델이 정말 쓰이는지 업체 말을 믿을 수밖에 없다. 증명 가능한 추론(provable inference)은 이 신뢰를 수학으로 대신하려는 기술이다. 앤트로픽은 개발자가 주장한 모델이 실제로 서비스되는지 확인하거나, 모델 바꿔치기·조작을 잡아내고, 규제 준수를 뒷받침하는 용도를 꼽았다.
연구진은 "추론의 암호학적 증명이 이 문제를 해결한다"고 썼다. 증명이 보장하는 내용은 "커밋된 모델을 실행하면 이 출력 토큰이 나온다"는 것이다. 가중치는 숨기지만 모델 구조는 드러난다.
플래시프루브 작동 방식
영지식 증명의 일종인 zkSNARK를 기반으로 하며, 연구진은 해시 함수로 구성해 양자 컴퓨터 공격에도 안전하다고 설명했다. 먼저 약 39분 걸리는 1회성 오프라인 단계에서 업체가 가중치에 대한 짧은 커밋을 공개한다. 이후 요청마다 증명 파일을 만들고, 커밋·프롬프트·답변을 가진 사람이면 누구나 이를 검증할 수 있다.
속도를 끌어올린 비결은 설계에 있다. 전문가 혼합(MoE) 모델에서 토큰마다 실제로 쓰이는 약 170억 개 파라미터만 증명하고, 요청을 사후에 묶어 처리하며, 가중치를 호스트 메모리에서 조각조각 불러와 GPU 한 장에 맞췄다. 프로토콜의 완전성·건전성·영지식성은 정리 증명기 린(Lean)으로 형식 검증했다.
실험에는 약 232GB 크기의 라마 4 매버릭 공개 4비트 버전과 CPU 24코어를 붙인 80GB H100 한 장을 썼다. 검증에는 24스레드로 약 17초, 단일 스레드로 약 21초가 걸렸다.
기존 영지식 증명 시스템과 속도 비교
앤트로픽이 인용한 선행 연구를 보면 차이가 뚜렷하다. 2024년 발표된 zkLLM은 A100 한 장으로 LLaMA-2-13B를 초당 약 2.5토큰 처리했다. SASH의 증명기는 H100에서 라마 3.1 8B를 초당 약 1.25토큰, 딥프루브(DeepProve)는 GPT-2를 초당 약 2.9토큰 처리했다. 같은 매버릭 모델을 다룬 베르인프(VerInf)는 1,000토큰에 14.3시간이 걸렸고 증명 파일이 93.6GB에 달했다.
비용은 여전히 크다. 앤트로픽은 증명에 오픈소스 서빙 라이브러리 vLLM으로 모델을 돌릴 때보다 "약 70~95배의 GPU 시간"이 든다고 밝혔다.
배경: 앤트로픽 안전 로드맵
앤트로픽은 '프런티어 안전 로드맵'에서 2026년 9월 30일까지 증명 가능한 추론 시제품을 만들겠다고 했다. 회사는 추론 트래픽에 서명하고 신뢰할 수 있는 서버에서 다시 계산하는 별도 프로젝트로 이 목표를 달성했으며, 이후 목표 이름을 '추론 검증'으로 바꿨다고 설명했다. 플래시프루브는 이와 나란히 진행된 소프트웨어 방식으로, 하드웨어 기반 신뢰 실행 환경을 보완하는 접근이라는 게 연구진의 설명이다.
연구는 앤트로픽 프런티어 레드팀이 스위스 로잔연방공대(EPFL), MIT, 스타크웨어 연구자들과 함께 했다. 코드는 아파치 2.0 라이선스로 깃허브에 공개됐고, 모델 가중치는 포함되지 않아 메타의 라마 4 라이선스에 따라 따로 내려받아야 한다.
전망과 한계
연구진은 한계를 분명히 적었다. 정수화한 모델의 그리디 디코딩만 증명하므로 샘플링 출력과는 어긋날 수 있고, 문맥 길이도 1,024토큰으로 최신 챗봇에 한참 못 미친다. 빠른 C++ 코드가 린 프로토콜과 일치한다는 형식 보장은 없으며, 타이밍 부채널 공격도 범위 밖이다.
연구진은 "이 글은 중간 성과를 공유하려는 것이지 완성된 연구 과제가 아니다"라고 밝혔다.
자주 묻는 질문
플래시프루브가 모델 가중치를 노출하나? 아니다. 가중치는 숨기며, 모델 구조만 드러난다.
GPU 없이 검증할 수 있나? 그렇다. 검증은 CPU에서 돌아가며 앤트로픽 실험에서 약 17~21초 걸렸다.
상용 챗봇에 바로 쓸 수 있나? 아직은 아니다. 그리디 디코딩과 1,024토큰 문맥으로 제한된 연구 시제품이다.
참고 자료
- Progress on Provable Inference for Large Language Models — Anthropic(2026년 11월 2일)
- anthropics/FlashProve — GitHub

댓글 0
현재 댓글 작성이 비활성화되어 있습니다.