
アンソロピック、回答したAIモデルを証明する技術を公開
アンソロピックは11月2日、AIの回答が事前にコミットしたモデルから出たことを重みを明かさずに暗号学的に証明するオープンソース試作システム「FlashProve」を公開した。H100 1基で4000億パラメーターのLlama 4 Maverickを毎秒約110トークン証明する。
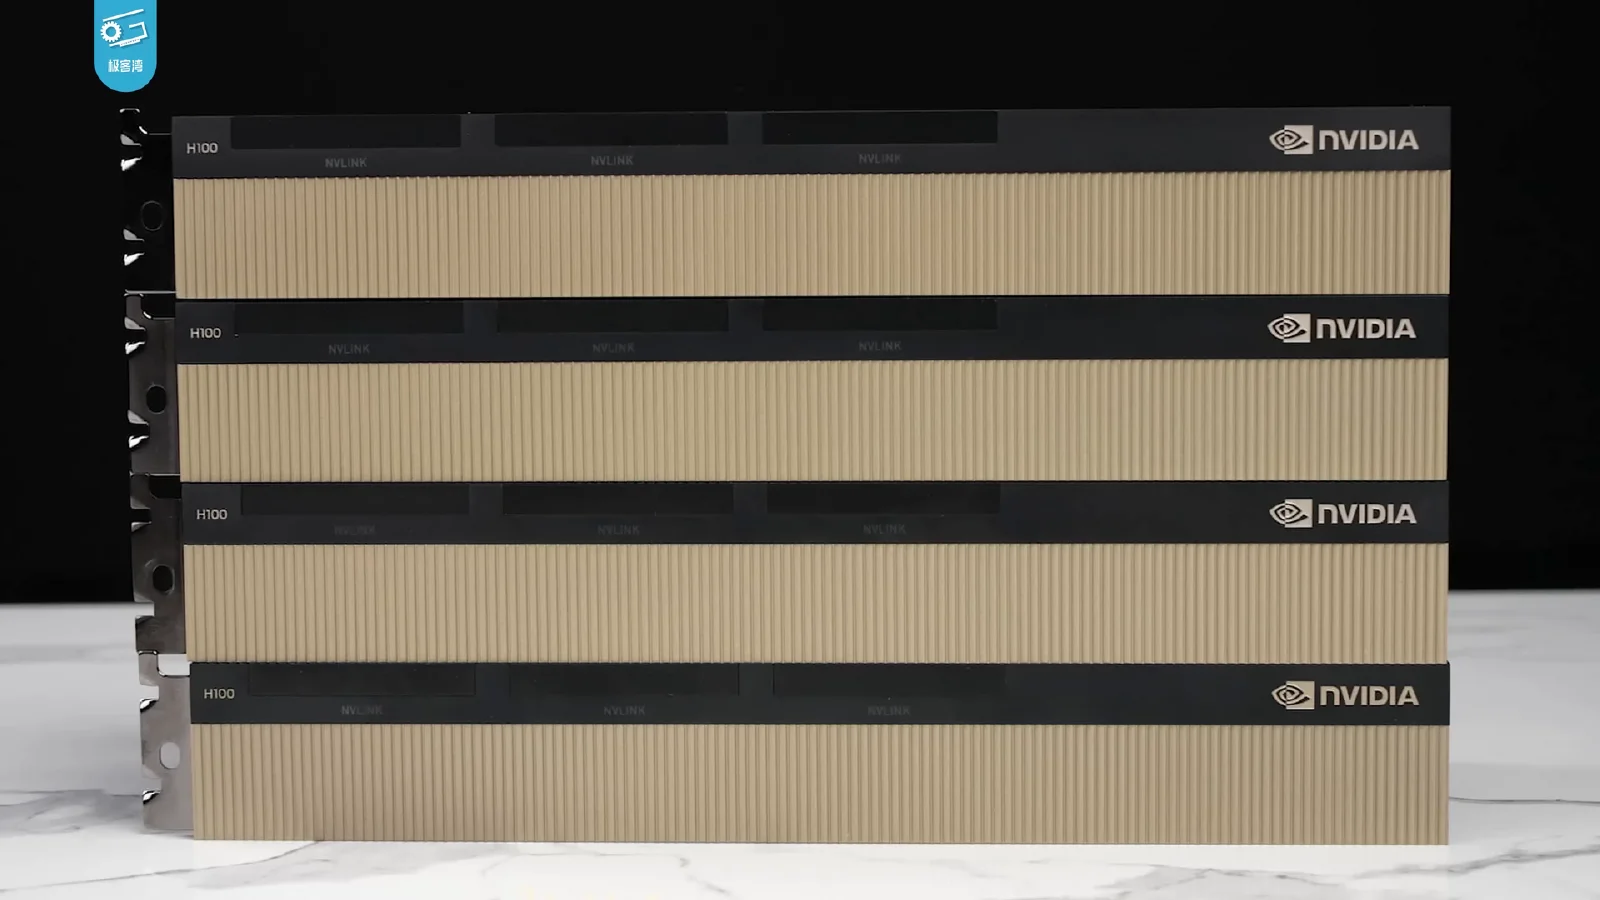
米アンソロピックは11月2日、AIの回答がどのモデルから出力されたかを、モデルの重みを明かさずに暗号学的に証明するオープンソースの研究用試作システム「FlashProve(フラッシュプルーブ)」を公開した。エヌビディアのGPU「H100」1基で、メタの4000億パラメーターのモデル「Llama 4 Maverick」の出力を毎秒約110トークンの速さで証明でき、これまでに公開されたオープンソースの仕組みを大きく上回る。
ポイント
- 提供事業者が事前に「コミット」したモデルが実際にその回答を出したかを、誰でも一般的なCPUで検証できる。
- H100 1基で毎秒約110トークンを証明し、1024トークンのリクエストに対する証明ファイルは約19MB。ただし通常の推論に比べGPU時間は70〜95倍かかる。
- アンソロピックは「途中経過」と位置付ける。対象は貪欲法(グリーディー)デコード、整数化した重み、1024トークンの文脈に限られる。
「証明可能な推論」とは何か
AI企業がAPIでモデルを提供する場合、利用者は宣伝どおりのモデルが本当に使われているかを事業者の説明に頼るしかない。証明可能な推論(provable inference)は、この信頼を数学で置き換えようとする技術である。アンソロピックは、開発者が主張するモデルが実際に提供されているかの確認、モデルのすり替えや改ざんの検出、規制順守の裏付けといった用途を挙げた。
研究チームは「推論の暗号学的証明がこの問題を解決する」と記した。証明の内容は「コミットされたモデルを実行すると、これらの出力トークンが生成される」というものだ。重みは秘匿されるが、モデルの構造は明らかになる。
FlashProveの仕組み
基盤はゼロ知識証明の一種であるzkSNARKで、ハッシュ関数で構成しているため耐量子安全性があるという。まず約39分かかる1回限りのオフライン段階で、事業者が重みに対する短いコミットメントを公開する。その後はリクエストごとに証明ファイルを生成し、コミットメント・プロンプト・回答を持つ人なら誰でも検証できる。
高速化の鍵は設計にある。混合エキスパート(MoE)モデルで1トークンごとに実際に使われる約170億パラメーターだけを証明し、リクエストを事後にまとめて処理するうえ、重みをホストメモリーから分割して読み込むことでGPU 1基に収めた。プロトコルの完全性・健全性・ゼロ知識性は定理証明支援系「Lean」で形式検証している。
実験では約232GBあるLlama 4 Maverickの公開4ビット版と、CPU 24コアを備えた80GBのH100 1基を使った。検証は24スレッドで約17秒、1スレッドで約21秒だった。
従来のゼロ知識証明システムとの速度比較
アンソロピックが引用した先行研究と比べると差は明らかだ。2024年発表のzkLLMは、A100 1基でLLaMA-2-13Bを毎秒約2.5トークン処理した。SASHの証明器はH100でLlama 3.1 8Bを毎秒約1.25トークン、DeepProveはGPT-2を毎秒約2.9トークンだった。同じMaverickを扱ったVerInfは1000トークンに14.3時間を要し、証明ファイルは93.6GBに達したという。
ただしコストは依然として大きい。アンソロピックによると、証明にはオープンソースの推論ライブラリー「vLLM」でモデルを動かす場合の「約70〜95倍のGPU時間」がかかる。
背景:アンソロピックの安全ロードマップ
アンソロピックは「フロンティア安全ロードマップ」で、2026年9月30日までに証明可能な推論の試作品を開発する目標を掲げていた。同社は、推論トラフィックに署名し信頼できるサーバーで再計算する別プロジェクトでこの目標を達成し、その後目標の名称を「推論検証」に改めたと説明している。FlashProveはこれと並行するソフトウエアのみの手法で、ハードウエアによる信頼実行環境を補完するものと位置付けられている。
研究はアンソロピックのフロンティア・レッドチームが、スイス連邦工科大学ローザンヌ校(EPFL)、マサチューセッツ工科大学(MIT)、スタークウェアの研究者と共同で行った。コードはApache 2.0ライセンスでGitHubに公開されたが、モデルの重みは含まれず、メタのLlama 4ライセンスに従って別途ダウンロードする必要がある。
今後の課題
研究チームは限界も明記した。証明できるのは整数化したモデルの貪欲法デコードのみで、サンプリングによる出力とは食い違う可能性がある。文脈長も1024トークンで、最新のチャットAIに遠く及ばない。高速なC++実装がLeanのプロトコルと一致する形式的保証はなく、タイミングによるサイドチャネル攻撃も対象外である。
研究チームは「この記事は途中経過を共有するもので、完成した研究計画ではない」としている。
よくある質問
FlashProveでモデルの重みは漏れるのか。 漏れない。重みは秘匿され、明らかになるのはモデルの構造だけである。
GPUなしで検証できるのか。 できる。検証はCPUで動作し、アンソロピックの実験では約17〜21秒だった。
商用チャットボットにすぐ使えるのか。 まだ使えない。貪欲法デコードと1024トークンの文脈に限られた研究用試作品である。
参考資料
- Progress on Provable Inference for Large Language Models — Anthropic(2026年11月2日)
- anthropics/FlashProve — GitHub

コメント 0
現在コメントの投稿は無効になっています。