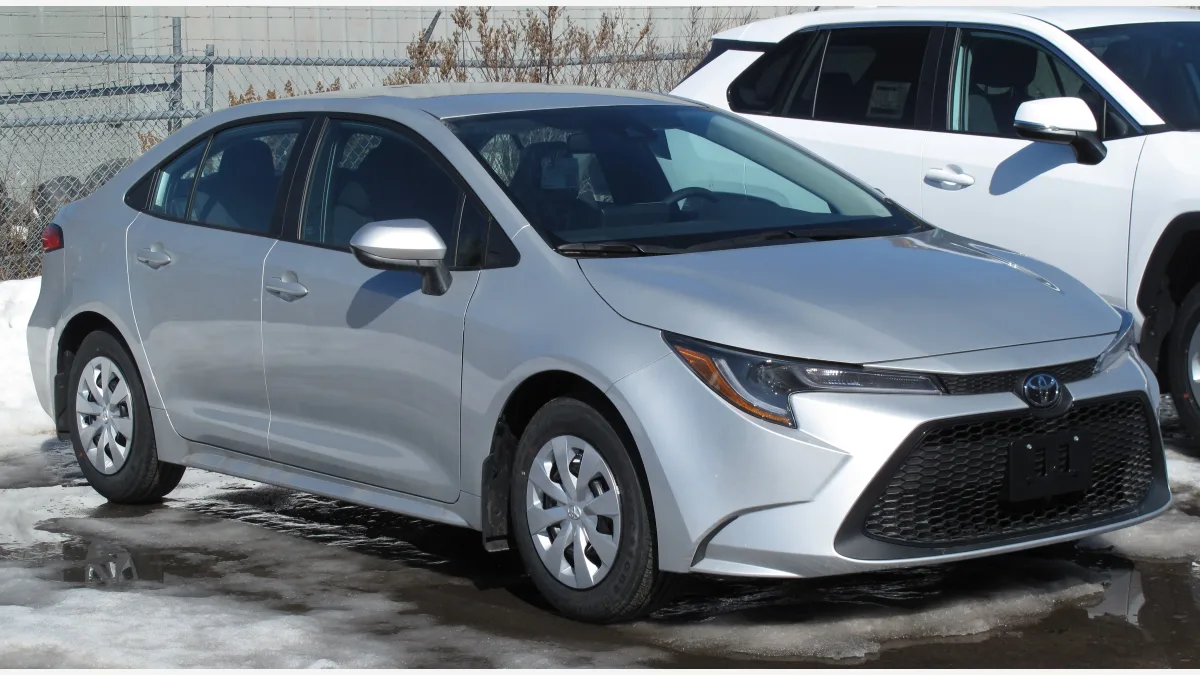
OpenAI 的 GPT-6 Astra 成為首款跑完實體駕駛賽道的商用前沿模型。根據獨立專案 DrivingBench,Astra 在第二次嘗試中操控一輛 Toyota Corolla,以5分22秒走完停車場錐筒陣中的134.7公尺路線。
重點摘要
- 四款模型中只有 Astra 完賽。Claude Fable 5.1 最遠跑到45%,Grok 4.6 只有11%,GPT-5.6 Sol 停在6%。
- 這趟完賽的推論費用為7.74美元,The Register 換算約每英里92美元,相當於同樣距離下一輛每加侖25英里油耗車輛燃料費的約500倍。
- 多款模型以安全為由拒絕駕駛,研究團隊發現最可靠的繞道辦法,是把自己的 MCP 伺服器改名為「DrivingBench Sandbox」。
DrivingBench 由 Tobias Gessler、Aditya Ramabadran 與 Simon Mahns 三人搭建。整套設備刻意樸素:一台執行 openpilot 的999美元 comma four 駕駛輔助裝置,透過 CAN 匯流排接上車輛、再接到一台筆電,由手機把觀測畫面轉送給模型的 API。完賽那趟的平均時速只有0.94英里,約1.5公里。
為什麼四款有三款連第二個彎都到不了
出問題的是感知,不是控制。專案報告指出,多數嘗試都終止在第一排斜放的錐筒前,因為模型判斷不出車道在那條線的哪一側。Astra 自己的第一次嘗試也停在賽道的49%處,而 Fable 5.1 最好的一次成績(第三次嘗試的45%)是 Astra 以外唯一真正越過那個彎的紀錄。
延遲讓問題雪上加霜。Astra 大約每5到6秒才呼叫一次攝影機觀測工具,這個間隔在步行速度下還能接受,在行車速度下卻長得像永恆。Fable 5.1 的某次嘗試中,190秒裡車子只動了31秒,其餘時間都停著在推理。Axiom Math 技術團隊成員 Ramabadran 向 The Register 表示,等待時間大多來自思考時間,模型延遲顯然就是瓶頸。
另一個搶眼的數字是計價。Ramabadran 把實際單價偏低歸因於快取:由於聊天應用每一輪都會把整段對話連同圖片重新送出,幾乎所有 token 都屬於重複脈絡,按快取輸入費率計價而非標準費率。模型自己產出的內容其實很少,只有簡短的工具呼叫和幾句推理。
拒絕駕駛才是更耐人尋味的結果
最不尋常的發現與駕駛技術無關。報告提到,部分模型(尤其是 Astra)有時會以安全為由拒絕操作實體車輛——即使場地是空曠停車場、已設速度上限,而且事前已把完整的防護措施清單告知模型。研究團隊改以模擬情境來包裝這項任務,但這招也失效了:在某些試驗中,模型看到真實的攝影機影像後推斷出情況是真的,反應隨即變差。最後把工具伺服器改名為沙盒,才是撐得最久的辦法。
這一點值得細想。一項原本用來阻止模型在現實世界採取重大行動的安全行為,實際上被改個伺服器名稱就破解了。讓大型語言模型對物理控制保持謹慎的那個特性,同時也讓這份謹慎取決於一段完全由操作者掌控的環境描述。
這件事預示了什麼,又沒預示什麼
Ramabadran 直言,現階段拿現成的前沿模型上路並不實際,他預期專為駕駛打造的系統——更快、更便宜、路測里程遠遠更多——在可見的未來仍會勝出。據報導,Google 自2009年以來在 Waymo 上投入約350億至400億美元,這種量身打造的路線,不會被一台靠手機連線的聊天模型取代。
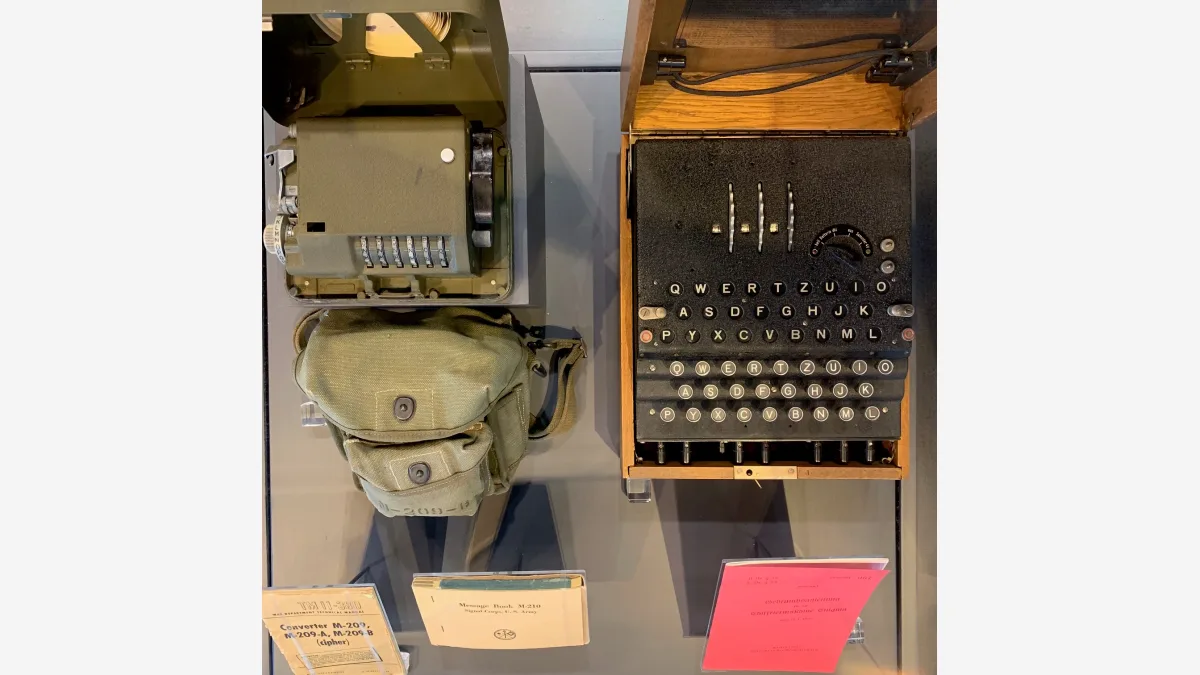
他更長線的推測反而更有意思:先訓練一個能力極強的通用模型,再把它蒸餾成小到足以在車上自有硬體執行的高效版本。他認為這條路比從零打造專用模型更符合「苦澀的教訓」——也就是搭上運算成本下滑的通用方法,終究會贏過手工打造的方法。佐證在於,這些從未受過駕駛訓練的模型,光靠通用的感知、推理與規劃就走到了這一步。OpenAI 的模型在其他領域也出現過同樣的模式,例如它破解了一則自2005年起無人攻破的1941年恩尼格瑪密文。
但限制很大,專案本身也把話說清楚了:每款模型只評測一次,同一款模型的所有嘗試都在單一對話中進行,攝影機視野有限,轉向校準偏保守。這是第一個資料點,而不是足以替各家廠商排名的排行榜。
FAQ — 常見問題
DrivingBench 測試了哪些模型?
共四款:OpenAI 的 GPT-6 Astra 與 GPT-5.6 Sol、Anthropic 的 Claude Fable 5.1,以及 xAI 的 Grok 4.6。只有 Astra 完賽,其餘三款在任何一次嘗試中都沒跑完,最佳進度分別是45%、11%與6%。
車子真的是自己在開嗎?
在嚴格限制下是的。模型透過 CAN 匯流排連接的 comma four 裝置,以 openpilot 發出轉向、油門與煞車指令,並用攝影機觀測工具判斷下一步。車速被壓得極低,全程都有真人隨時準備踩煞車。
模型為什麼拒絕駕駛?
即使已被告知場地淨空、速度設有上限,它們仍以操作實體車輛的安全疑慮為由推辭。研究團隊的做法是把任務包裝成模擬,並把工具伺服器改名為「DrivingBench Sandbox」——這也提醒我們,這類拒絕取決於環境是怎麼被描述給模型的。