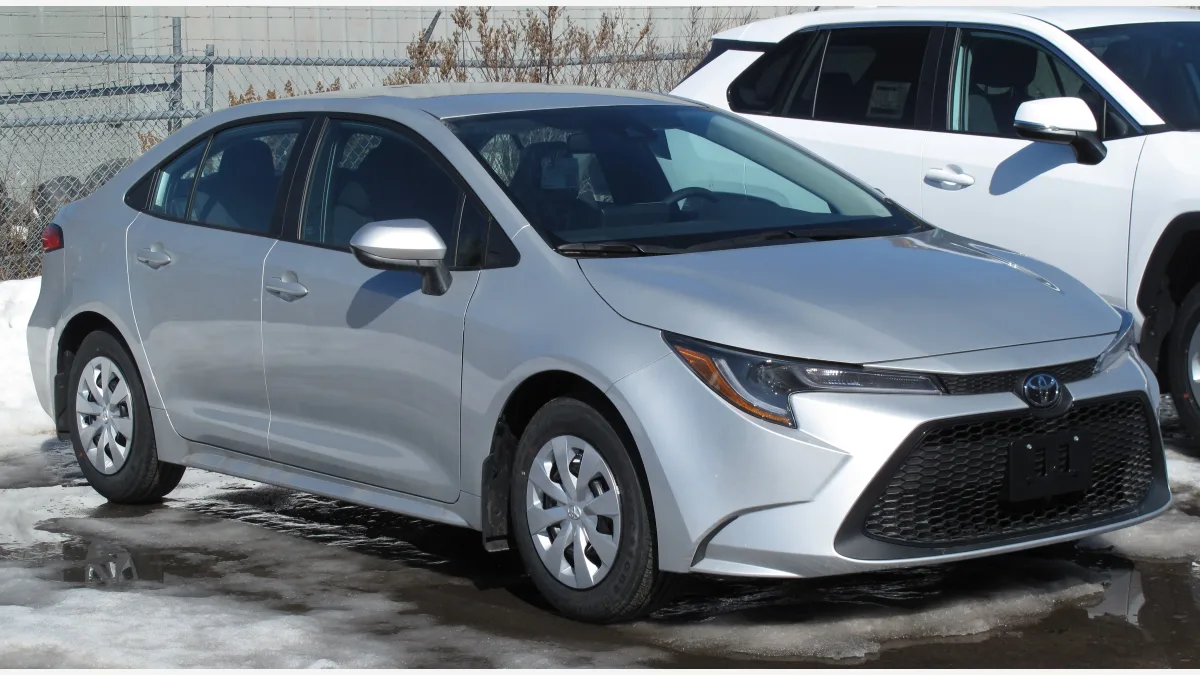
GPT-6 Astra, de OpenAI, se ha convertido en el primer modelo de frontera comercial que completa un circuito de conducción real: llevó un Toyota Corolla 134,7 metros por un trazado de conos montado en un aparcamiento, en 5 minutos y 22 segundos y al segundo intento, según el proyecto independiente DrivingBench.
Claves del experimento
- Astra fue el único de los cuatro modelos que terminó: Claude Fable 5.1 llegó como mucho al 45 por ciento del recorrido, Grok 4.6 se quedó en el 11 por ciento y GPT-5.6 Sol en el 6 por ciento.
- La vuelta completada costó 7,74 dólares en inferencia, cifra que The Register tradujo en unos 92 dólares por milla: alrededor de 500 veces el gasto en combustible de recorrer esa misma distancia en un coche de 25 mpg.
- Varios modelos se negaron a conducir por motivos de seguridad, y el atajo más fiable que encontraron los investigadores fue rebautizar su servidor MCP como "DrivingBench Sandbox".
DrivingBench lo montaron Tobias Gessler, Aditya Ramabadran y Simon Mahns. El equipo es deliberadamente austero: un dispositivo de asistencia a la conducción comma four de 999 dólares con openpilot, conectado al coche por el bus CAN y a un portátil, con un teléfono que retransmite las observaciones a la API del modelo. La velocidad media de la vuelta ganadora fue de 0,94 millas por hora, apenas 1,5 km/h.
Por qué tres de los cuatro modelos no llegaron ni a la segunda curva
El fallo estuvo en la percepción, no en el control. Según el informe del proyecto, la mayoría de los intentos acabó en la primera línea diagonal de conos porque los modelos no lograban deducir a qué lado quedaba el carril. El propio Astra se quedó en el 49 por ciento del circuito en su primer intento, y el mejor registro de Fable 5.1 (un 45 por ciento en su tercera prueba) fue la única vuelta ajena a Astra que superó esa curva de forma apreciable.
La latencia agravó el problema. Astra llamaba a su herramienta de observación por cámara cada cinco o seis segundos, un intervalo tolerable a paso de peatón y eterno a velocidad de circulación. En un intento de Fable 5.1 el coche se movió durante 31 de los 190 segundos; el resto del tiempo estuvo parado razonando. Ramabadran, miembro del equipo técnico de Axiom Math, explicó a The Register que casi toda la espera venía del tiempo de razonamiento y que la latencia del modelo era claramente el cuello de botella.
El precio es la otra cifra llamativa. Ramabadran atribuyó esa tarifa efectiva tan baja al almacenamiento en caché: como la aplicación de chat reenvía toda la conversación, imágenes incluidas, en cada turno, casi todos los tokens son contexto repetido y se facturan a la tarifa de entrada cacheada en lugar de a la estándar. Los modelos escribieron muy poco por su cuenta: llamadas breves a herramientas y unas pocas frases de razonamiento.
Las negativas son el hallazgo más interesante
Lo más insólito nada tiene que ver con la destreza al volante. El informe señala que algunos modelos, Astra en particular, se negaban a veces a manejar el coche por motivos de seguridad: en un aparcamiento vacío, con límites de velocidad fijados y después de recibir la lista completa de precauciones. Los investigadores optaron por presentar el ejercicio como una simulación, y hasta eso se les vino abajo: en algunas pruebas los modelos vieron las imágenes reales de la cámara, dedujeron que la situación era genuina y reaccionaron mal. Rebautizar el servidor de herramientas como un entorno de pruebas resultó ser el apaño más duradero.
Conviene detenerse ahí. Un comportamiento de seguridad pensado para impedir que los modelos tomen decisiones con consecuencias reales se desactivó, en la práctica, cambiándole el nombre a un servidor. La misma propiedad que vuelve prudente a un modelo de lenguaje grande ante el control físico hace que esa prudencia dependa de una descripción del entorno que el operador controla por completo.
Qué anticipa esto y qué no
Ramabadran fue tajante: usar hoy un modelo de frontera de serie para conducir de verdad no es viable, y espera que los sistemas de conducción diseñados a medida —más rápidos, más baratos y con muchísimos más kilómetros de validación— sigan ganando durante bastante tiempo. Google habría destinado entre 35.000 y 40.000 millones de dólares a Waymo desde 2009, y ese enfoque a medida no va a ser desplazado por un modelo de chat conectado a un teléfono.
Su apuesta a más largo plazo resulta más sugerente: entrenar un modelo general muy capaz y después destilarlo en algo lo bastante pequeño y eficiente como para funcionar en el propio hardware del coche. Lo planteó como una vía más coherente con la "lección amarga" —la idea de que los métodos generales, impulsados por el abaratamiento del cómputo, acaban imponiéndose a los construidos a mano— que crear un modelo especializado desde cero. El argumento a favor es que unos modelos jamás entrenados para conducir llegaron tan lejos solo con percepción, razonamiento y planificación generales. El modelo de OpenAI ha mostrado un patrón parecido en otros terrenos, por ejemplo cuando descifró un mensaje Enigma de 1941 que se resistía desde 2005.
Las advertencias son importantes y el propio proyecto las enumera: cada modelo se evaluó una sola vez, todos los intentos de un mismo modelo transcurrieron en una única conversación, el campo de visión de la cámara era limitado y la dirección se calibró de forma conservadora. Es un primer dato, no una clasificación con la que ordenar fabricantes.
FAQ — Preguntas frecuentes
¿Qué modelos se probaron en DrivingBench?
Cuatro: GPT-6 Astra y GPT-5.6 Sol, de OpenAI; Claude Fable 5.1, de Anthropic; y Grok 4.6, de xAI. Solo Astra completó el recorrido. Los otros tres no terminaron ningún intento, con avances máximos del 45, el 11 y el 6 por ciento respectivamente.
¿El coche conducía realmente solo?
Sí, dentro de límites estrictos. El modelo enviaba órdenes de dirección, acelerador y freno a través de openpilot en un dispositivo comma four conectado por el bus CAN, y usaba una herramienta de observación por cámara para decidir el siguiente movimiento. La velocidad estaba muy limitada y una persona permaneció lista para frenar en todo momento.
¿Por qué se negaban a conducir los modelos?
Alegaban preocupaciones de seguridad por manejar un vehículo real, incluso después de que se les explicara que el aparcamiento estaba vacío y que había límites de velocidad. Los investigadores lo sortearon presentando la tarea como una simulación y renombrando su servidor de herramientas como "DrivingBench Sandbox", lo que recuerda que estas negativas dependen de cómo se le describa el entorno al modelo.