
2840億パラメータのDeepSeek、GPUなし64GBで動作
オープンソースのllama-modchipがv2.4.0で、2840億パラメータのDeepSeek-V4-FlashをGPUなしの64GB PCで毎秒9.06〜9.95トークンで動かしたと自社測定値を公開した。
オープンソースプロジェクトのllama-modchipは11月4日公開のv2.4.0で、パラメータ数2840億のDeepSeek-V4-Flashを、グラフィックスカードなしのメモリ64GBのPCで動かせると発表した。GitHubアカウントのsynchopateが公開したもので、11月8日にHacker Newsへ投稿され355ポイントを集めた。ただし大型モデルの速度はプロジェクト自身の測定値であり、生成速度は毎秒10トークン前後にとどまる。
要点
- v2.4.0はDeepSeek-V4-Flashの圧縮版を76.87GiBから56.56GiBへ縮小し、64GBのメモリにスワップなしで収めたとプロジェクトは説明している。
- GPUなしの16コアAMD Ryzen 9 9955HX、コンテキスト25万6000トークンの条件で、生成速度は毎秒9.06〜9.95トークンである。
- 「ロスレス」は同じ圧縮ファイルでのパッチ適用前後の比較であり、DeepSeekの元の重みとの比較ではない。
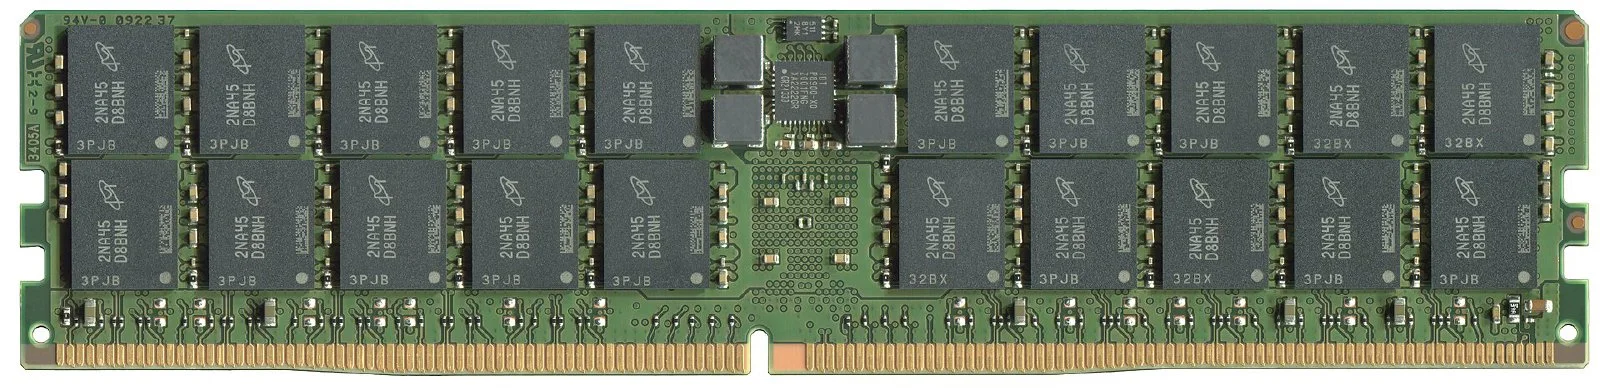
DeepSeekの2840億パラメータモデルを64GBに収めた仕組み
DeepSeekのモデルカードによると、V4-Flashの総パラメータ数は2840億、1トークンの処理で使う活性パラメータは130億である。
新ビルドのモデルカードは、既存のコミュニティ製量子化ファイル(76.87GiB)が64GBのLinuxマシンの実効メモリ約62.5GiBを超えると指摘する。llama-modchipはUnslothのこのファイルをさらに圧縮し、ルーティング用エキスパートの大半を重みあたり約1.56ビットに落とした。
| 項目 | 従来ビルド | llama-modchip v2.4.0 |
|---|---|---|
| ファイルサイズ | 76.87GiB | 56.56GiB |
| 25万6000トークン時のメモリ | 64GiB超 | 57.61〜58.9GiB |
| プロンプト処理 | 毎秒25.0トークン | 毎秒43.16〜44.36トークン |
| 生成 | 毎秒5.91トークン | 毎秒9.06〜9.95トークン |
高速化はllama.cppをCPUに合わせて改修したパッチによるとリリースノートは説明する。起点の数値はREADMEが毎秒5.91トークン、モデルカードは毎秒6.41トークンとしている。毎秒9.06トークンなら、500トークンの回答に約55秒かかる計算である。
「ロスレス」が意味するもの
プロジェクトは既定モードのロジットコサイン類似度が1.00000で、ビット単位で一致すると説明する。READMEによれば、これは同じ56.56GiBのチェックポイントをパッチなしのランタイムで動かした場合との比較である。速度パッチが圧縮ファイルの出力を変えないことは示すが、圧縮そのものでどれだけ品質が落ちたかは示さない。DeepSeekの元の重みは、エキスパートにFP4、その他の大半にFP8を用いている。
AI Newswayが確認した文書には、300億パラメータのNemotronビルドの100点満点の品質スコアはあるが、2840億ビルドの同等のスコアは見当たらなかった。AI Newswayは実機での検証を行っていない。
ローカルLLM利用者にとっての意味
大型のオープンモデルを手元で動かすには、これまで高価なユニファイドメモリ機やGPUが必要だった。AI Newswayが10月に取り上げたantirez氏のds4エンジンの参考値では、128GBのM5 Maxがコンテキスト3万2768トークンで毎秒34.4トークンを出している。llama-modchipはその速度を手放す代わりに、より安価なハードウェアを選んだ形だ。コンテキストもモデル本来の100万トークンより短い。
専用エンジンも欠かせない。READMEによると、パッチなしのllama.cpp、Ollama、LM Studioは未知のテンソル形式としてファイルを受け付けない。ベースも0731チェックポイントであり、DeepSeekはその後V4.1 Flashを公開している。
今後の焦点
11月8日にはリポジトリのIssue欄にベンチマークの投稿が相次ぎ、v2.4.0以降のコミットは17件に達した。FAQが挙げる第三者の測定は小型のNemotronモデルに関するものであり、2840億ビルドの外部での再現と品質ベンチマークの公開が次の焦点となる。
よくある質問
メモリ32GBのPCでDeepSeek-V4-Flashは動くか
2840億ビルドは57.61〜58.9GiBを要するため難しい。プロジェクトは16〜32GBのPC向けに、エヌビディアの300億パラメータモデルNemotron 3.5の14.35GiBビルドを案内している。
オープンソースか
そうだ。リポジトリのライセンス表示はApache 2.0である。
参考資料
- GitHub - synchopate/llama-modchip — GitHub
- Release v2.4.0 · synchopate/llama-modchip — GitHub(2026年11月4日)
- llama-modchip/FAQ.md — GitHub
- Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF — Hugging Face
- deepseek-ai/DeepSeek-V4-Flash — Hugging Face
- Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU — Hacker News(2026年11月8日)

コメント 0
現在コメントの投稿は無効になっています。