
DeepSeek 2840억 모델, GPU 없이 64GB PC서 구동
오픈소스 프로젝트 llama-modchip이 v2.4.0에서 2,840억 매개변수 DeepSeek-V4-Flash를 GPU 없는 64GB PC에서 초당 9.06~9.95토큰으로 돌렸다고 자체 측정치를 공개했다.
오픈소스 프로젝트 llama-modchip이 11월 4일 공개한 v2.4.0에서 매개변수 2,840억 개짜리 DeepSeek-V4-Flash를 그래픽카드 없이 메모리 64GB PC에서 돌릴 수 있다고 밝혔다. 이 프로젝트는 11월 8일 해커뉴스에 올라와 355점을 받았다. 다만 대형 모델의 속도 수치는 프로젝트 자체 측정값이고, 생성 속도는 초당 10토큰 안팎이다.
핵심 정리
- v2.4.0은 DeepSeek-V4-Flash 압축본을 76.87GiB에서 56.56GiB로 줄여 64GB 메모리 안에 스왑 없이 올린다고 프로젝트 측은 설명했다.
- GPU 없는 16코어 AMD 라이젠 9 9955HX, 25만6,000토큰 컨텍스트 기준 생성 속도는 초당 9.06~9.95토큰이다.
- '무손실'은 같은 압축 파일에서 패치 전후를 비교한 표현으로, DeepSeek 원본 가중치와 비교한 결과가 아니다.
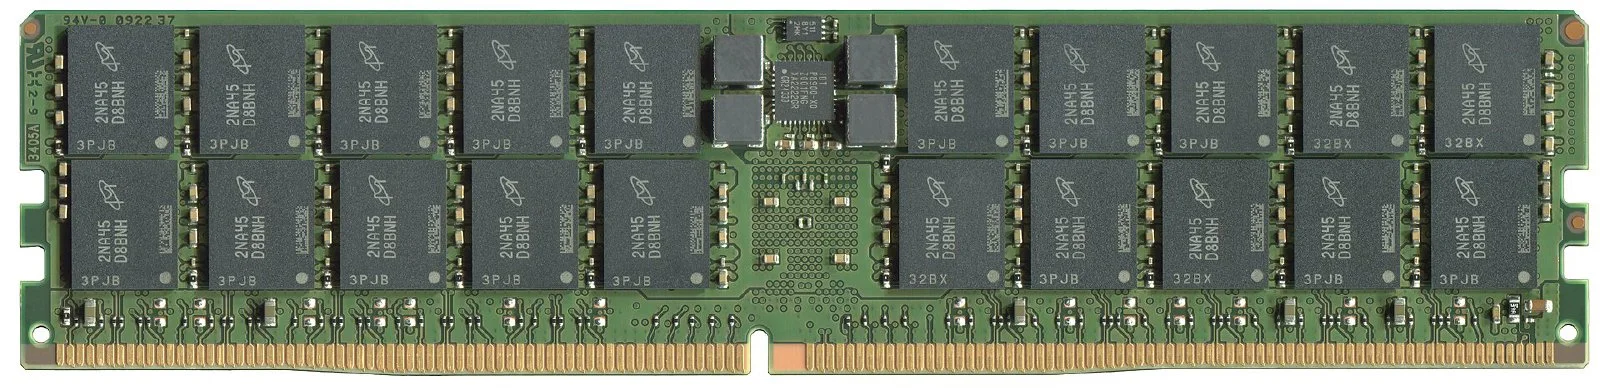
DeepSeek 2840억 매개변수 모델, 64GB에 어떻게 넣었나
DeepSeek의 모델 카드에 따르면 V4-Flash의 전체 매개변수는 2,840억 개, 토큰 하나를 처리할 때 쓰는 활성 매개변수는 130억 개다.
새 빌드의 모델 카드는 76.87GiB짜리 기존 커뮤니티 양자화 파일이 64GB 리눅스 PC의 실사용 메모리 약 62.5GiB를 넘긴다고 지적한다. llama-modchip은 언슬로스(Unsloth)의 이 파일을 다시 압축해 라우팅 전문가 대부분을 가중치당 약 1.56비트로 낮췄다.
| 항목 | 기존 빌드 | llama-modchip v2.4.0 |
|---|---|---|
| 파일 크기 | 76.87GiB | 56.56GiB |
| 25만6,000토큰 컨텍스트 메모리 | 64GiB 초과 | 57.61~58.9GiB |
| 프롬프트 처리 | 초당 25.0토큰 | 초당 43.16~44.36토큰 |
| 생성 | 초당 5.91토큰 | 초당 9.06~9.95토큰 |
속도 향상은 llama.cpp를 CPU에 맞춰 고친 패치에서 나왔다고 릴리스 노트는 설명한다. 출발점은 README가 초당 5.91토큰, 모델 카드가 6.41토큰으로 다르다. 초당 9.06토큰이면 500토큰 답변에 약 55초가 걸린다.
'무손실'이 뜻하는 것과 뜻하지 않는 것
프로젝트는 기본 모드의 로짓 코사인 유사도가 1.00000이라며 비트 단위로 같다고 밝혔다. README에 따르면 이는 같은 56.56GiB 체크포인트를 패치하지 않은 런타임과 비교한 값이다. 압축 자체로 품질이 얼마나 떨어졌는지를 보여 주는 수치는 아니다. DeepSeek 원본은 전문가 매개변수에 FP4, 나머지 대부분에 FP8을 쓴다.
AI Newsway가 확인한 문서에는 300억 매개변수 Nemotron 빌드의 100점 만점 품질 점수는 있지만, 2,840억 빌드의 같은 점수는 없었다. AI Newsway가 직접 실행해 보지는 않았다.
로컬 LLM 사용자에게 의미
AI Newsway가 10월 다룬 antirez의 ds4 엔진 참고 표에서는 128GB M5 맥스가 3만2,768토큰 컨텍스트에서 초당 34.4토큰을 냈다. llama-modchip의 25만6,000토큰 컨텍스트도 모델 본래의 100만 토큰보다는 짧다.
전용 엔진도 필요하다. README에 따르면 패치하지 않은 llama.cpp, 올라마, LM 스튜디오는 알 수 없는 텐서 형식 오류로 파일을 거부한다. 기반 모델도 0731 체크포인트로, DeepSeek은 이후 V4.1 Flash를 내놓았다.
전망
FAQ가 인용한 제3자 측정은 작은 Nemotron 모델에 관한 것이어서, 2,840억 빌드의 외부 재현과 품질 벤치마크 공개가 다음 관전 포인트다.
자주 묻는 질문
메모리 32GB PC에서도 DeepSeek-V4-Flash를 돌릴 수 있나?
2,840억 빌드는 57.61~58.9GiB가 필요해 어렵다. 프로젝트는 16~32GB PC에 엔비디아 300억 매개변수 Nemotron 3.5의 14.35GiB 빌드를 권한다.
오픈소스인가?
그렇다. 저장소 라이선스 표시는 아파치 2.0이다.
참고 자료
- GitHub - synchopate/llama-modchip — GitHub
- Release v2.4.0 · synchopate/llama-modchip — GitHub(2026년 11월 4일)
- llama-modchip/FAQ.md — GitHub
- Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF — Hugging Face
- deepseek-ai/DeepSeek-V4-Flash — Hugging Face
- Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU — Hacker News(2026년 11월 8일)

댓글 0
현재 댓글 작성이 비활성화되어 있습니다.