OpenAI의 GPT-6 Astra가 실제 주행 코스를 완주한 첫 상용 프런티어 모델이 됐다. 독립 프로젝트 DrivingBench에 따르면 Astra는 두 번째 시도에서 토요타 코롤라를 몰아 주차장에 깔린 콘 코스 134.7m를 5분 22초 만에 통과했다.
핵심 요약
- 4종 중 완주한 모델은 Astra뿐이었다. Claude Fable 5.1은 최대 45%, Grok 4.6은 11%, GPT-5.6 Sol은 6% 지점에서 멈췄다.
- 완주 주행에 든 추론 비용은 7.74달러였다. The Register는 이를 1마일당 약 92달러로 환산했는데, 연비 25mpg 차량이 같은 거리를 가는 연료비의 약 500배다.
- 여러 모델이 안전을 이유로 운전을 거부했고, 연구진이 찾아낸 가장 확실한 우회책은 MCP 서버 이름을 "DrivingBench Sandbox"로 바꾸는 것이었다.
DrivingBench는 토비아스 게슬러, 아디티아 라마바드란, 사이먼 만스가 함께 꾸렸다. 장비 구성은 의도적으로 소박하다. openpilot을 돌리는 999달러짜리 comma four 운전자 보조 장치를 CAN 버스로 차량에, 케이블로 노트북에 연결했고, 스마트폰이 관측 정보를 모델 API로 중계했다. 완주 주행의 평균 속도는 시속 0.94마일, 약 1.5km에 그쳤다.
4종 중 3종이 두 번째 코너에도 못 간 이유
실패는 제어가 아니라 인식에서 났다. 프로젝트 보고서를 보면 대부분의 시도가 첫 대각선 콘 구간에서 끝났다. 모델이 그 선의 어느 쪽에 주행 차선이 있는지 판단하지 못했기 때문이다. Astra도 첫 시도에서는 코스의 49% 지점에서 멈췄고, Fable 5.1의 최고 기록인 세 번째 시도 45%가 Astra 외 모델 중 그 코너를 의미 있게 넘어선 유일한 사례였다.
지연 시간이 문제를 키웠다. Astra는 카메라 관측 도구를 대략 5~6초에 한 번 호출했다. 걷는 속도에서는 견딜 만해도 주행 속도에서는 영원에 가까운 간격이다. Fable 5.1의 한 시도에서는 190초 중 차가 움직인 시간이 31초뿐이었고, 나머지는 멈춰 선 채 추론하는 데 쓰였다. Axiom Math 기술 스태프인 라마바드란은 The Register에 대기 시간 대부분이 사고 시간에서 나왔으며 모델 지연이 명백한 병목이었다고 밝혔다.
또 하나의 화제는 비용이다. 라마바드란은 실질 단가가 낮게 나온 이유로 캐싱을 꼽았다. 채팅 애플리케이션이 매 턴마다 이미지를 포함한 대화 전체를 다시 보내는 구조라, 거의 모든 토큰이 반복 컨텍스트로 분류돼 표준 단가가 아닌 캐시 입력 단가로 과금됐다는 설명이다. 모델이 직접 생성한 분량은 짧은 도구 호출과 몇 문장의 추론 정도로 적었다.
진짜 흥미로운 결과는 거부 반응이다
가장 이례적인 발견은 운전 실력과 무관하다. 보고서는 일부 모델, 특히 Astra가 안전을 이유로 실제 차량 조작을 거부하는 경우가 있었다고 적었다. 텅 빈 주차장이고 속도 상한이 걸려 있으며 안전 조치 목록을 모두 알려준 뒤에도 그랬다. 연구진은 이 작업을 시뮬레이션으로 포장하는 방식을 택했지만 그마저 무너졌다. 일부 시도에서 모델이 실제 카메라 이미지를 보고 상황이 진짜임을 알아챈 뒤 반응이 나빠졌다. 결국 도구 서버 이름을 샌드박스로 바꾸는 방법이 가장 오래 버텼다.
곱씹어 볼 대목이다. 모델이 현실에 실제 영향을 주는 행동을 하지 못하게 막으려던 안전 장치가, 현실에서는 서버 이름을 바꾸는 것만으로 뚫렸다. 대규모 언어 모델이 물리적 제어에 신중해지게 만드는 바로 그 성질이, 그 신중함을 운영자가 마음대로 쓰는 환경 설명에 의존하게 만든다.
이 결과가 예고하는 것과 아닌 것
라마바드란은 기성 프런티어 모델을 실제 주행에 쓰는 것이 지금으로선 현실적이지 않다고 잘라 말했다. 더 빠르고 저렴하며 도로 검증을 훨씬 많이 거친 전용 주행 시스템이 당분간 우위를 지킬 것으로 본다. 구글은 2009년 이후 Waymo에 350억~400억 달러 규모를 투입한 것으로 알려졌다. 그런 맞춤형 접근을 스마트폰에 연결된 채팅 모델이 당장 밀어낼 수는 없다.
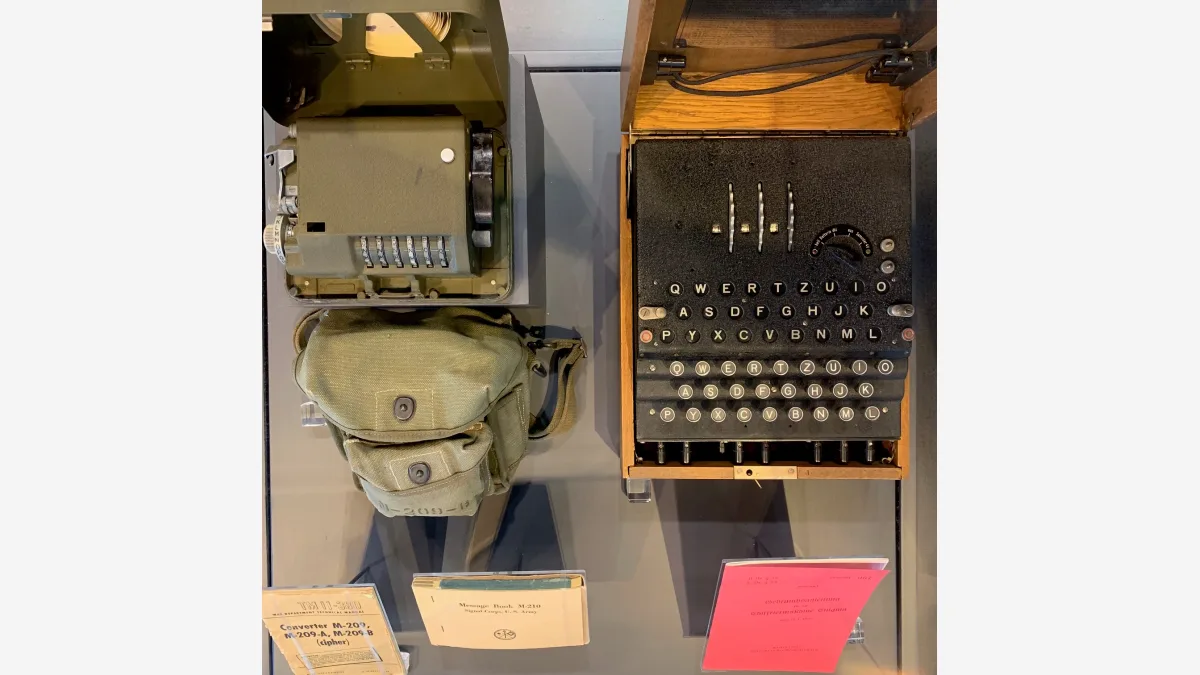
더 흥미로운 것은 그의 장기 전망이다. 아주 유능한 범용 모델을 먼저 학습시킨 뒤, 차량 자체 하드웨어에서 돌아갈 만큼 작고 효율적인 모델로 증류하자는 구상이다. 그는 이 방향이 특화 모델을 처음부터 만드는 것보다 '쓰라린 교훈', 즉 값싸지는 연산에 올라탄 범용 기법이 결국 수작업 기법을 이긴다는 주장에 더 부합한다고 설명했다. 근거는 운전을 한 번도 학습한 적 없는 모델들이 일반적인 인식·추론·계획 능력만으로 그 정도까지 갔다는 사실이다. OpenAI의 모델은 다른 영역에서도 같은 패턴을 보였다. 2005년 이후 아무도 풀지 못한 1941년 에니그마 암호문을 해독한 사례가 그렇다.
한계는 분명하고, 프로젝트도 이를 명시한다. 각 모델은 한 번씩만 평가했고, 한 모델의 모든 시도는 단일 대화 안에서 이뤄졌으며, 카메라 시야각이 제한적이었고 조향은 보수적으로 보정됐다. 이것은 첫 데이터 포인트이지, 업체 순위를 매길 만한 리더보드가 아니다.
FAQ — 자주 묻는 질문
DrivingBench에서 시험한 모델은 무엇인가?
네 종이다. OpenAI의 GPT-6 Astra와 GPT-5.6 Sol, Anthropic의 Claude Fable 5.1, xAI의 Grok 4.6이다. 완주한 것은 Astra뿐이다. 나머지 셋은 어떤 시도에서도 완주하지 못했고 최고 기록은 각각 45%, 11%, 6%였다.
차량이 실제로 스스로 주행했나?
엄격한 제한 아래에서 그렇다. 모델은 CAN 버스로 연결된 comma four 장치의 openpilot을 통해 조향·가속·제동 명령을 내렸고, 카메라 관측 도구로 다음 동작을 판단했다. 속도는 매우 낮게 제한했고 사람이 내내 브레이크를 밟을 준비를 하고 앉아 있었다.
모델들은 왜 운전을 거부했나?
텅 빈 주차장과 속도 상한을 알려준 뒤에도 실제 차량 조작에 안전 우려를 들었다. 연구진은 과제를 시뮬레이션으로 제시하고 도구 서버 이름을 "DrivingBench Sandbox"로 바꾸는 식으로 우회했다. 이런 거부가 환경을 모델에게 어떻게 설명하느냐에 달려 있음을 보여주는 대목이다.