
앤트그룹 LingBot-Touch, 로봇 촉각 센서 3종 통합
앤트그룹의 체화 AI 조직 로비앤트가 11월 9일 압저항식·자기식·시각촉각식 센서 데이터를 하나의 표현으로 묶는 오픈 촉각 파운데이션 모델 LingBot-Touch를 공개했다. 촉각 기록 4,983시간으로 사전학습했고 가장 작은 인코더는 매개변수 546만 개이며, 로봇 손 2종으로 실제 과제 26개를 시험했다.
중국 앤트그룹의 체화 AI(embodied AI) 조직 로비앤트(Robbyant)가 11월 9일 로봇 촉각 파운데이션 모델 'LingBot-Touch'를 공개했다. 서로 방식이 다른 세 종류의 촉각 센서 데이터를 하나의 표현으로 묶는 모델로, 로비앤트는 이렇게 만든 '촉각 토큰'을 기존 로봇 제어 정책에 그대로 끼워 넣어 정교한 손 조작 성능을 높일 수 있다고 밝혔다. 코드와 모델 체크포인트 2종은 아파치 2.0 라이선스로 풀었다.
핵심 정리
- 압저항식·자기식·시각촉각식 센서 데이터를 센서마다 따로 학습하지 않고 하나의 잠재 공간에 담는다.
- 사전학습 데이터는 촉각 기록 4,983시간, 46만4,431개 에피소드, 약 13억3,000만 프레임이다.
- 가장 작은 인코더는 매개변수 546만 개다. 학습 때 보지 못한 촉각 센서에도 옮겨 쓸 수 있다는 것이 개발진 설명이다. 모든 결과는 개발진 자체 수치다.
LingBot-Touch란 무엇인가
로봇용 촉각 센서는 방식이 제각각이다. 압저항식 패드는 누르는 힘을, 자기식 스킨은 3축 힘을 재고, 시각촉각식 센서는 말랑한 표면이 눌리는 모습을 카메라로 읽어 접촉을 추정한다. 논문 저자들은 센서마다 "대체할 수 없는 강점과 고유한 약점"이 있다고 적었다.
LingBot-Touch는 센서별 토크나이저가 공용 '햅틱 트랜스포머'에 신호를 넘기는 구조다. 원시 신호를 그대로 맞히는 대신 가려진 촉각 구간을 잠재 공간에서 예측하는 JEPA 방식으로 학습했다. 손끝마다 다른 센서 배치는 공통 좌표계로 옮겨 처리한다.
촉각 데이터 4,983시간, 실험은 어떻게 했나
로비앤트 프로젝트 페이지에 따르면 사전학습 데이터는 촉각 장갑과 로봇 손에서 모았다. 압저항식이 2,197시간으로 가장 많다.
| 센서 방식 | 시간 | 에피소드 |
|---|---|---|
| 압저항식 | 2,197 | 86,906 |
| 시각촉각식 | 1,650 | 82,654 |
| 자기식 | 1,136 | 294,871 |
| 합계 | 4,983 | 464,431 |
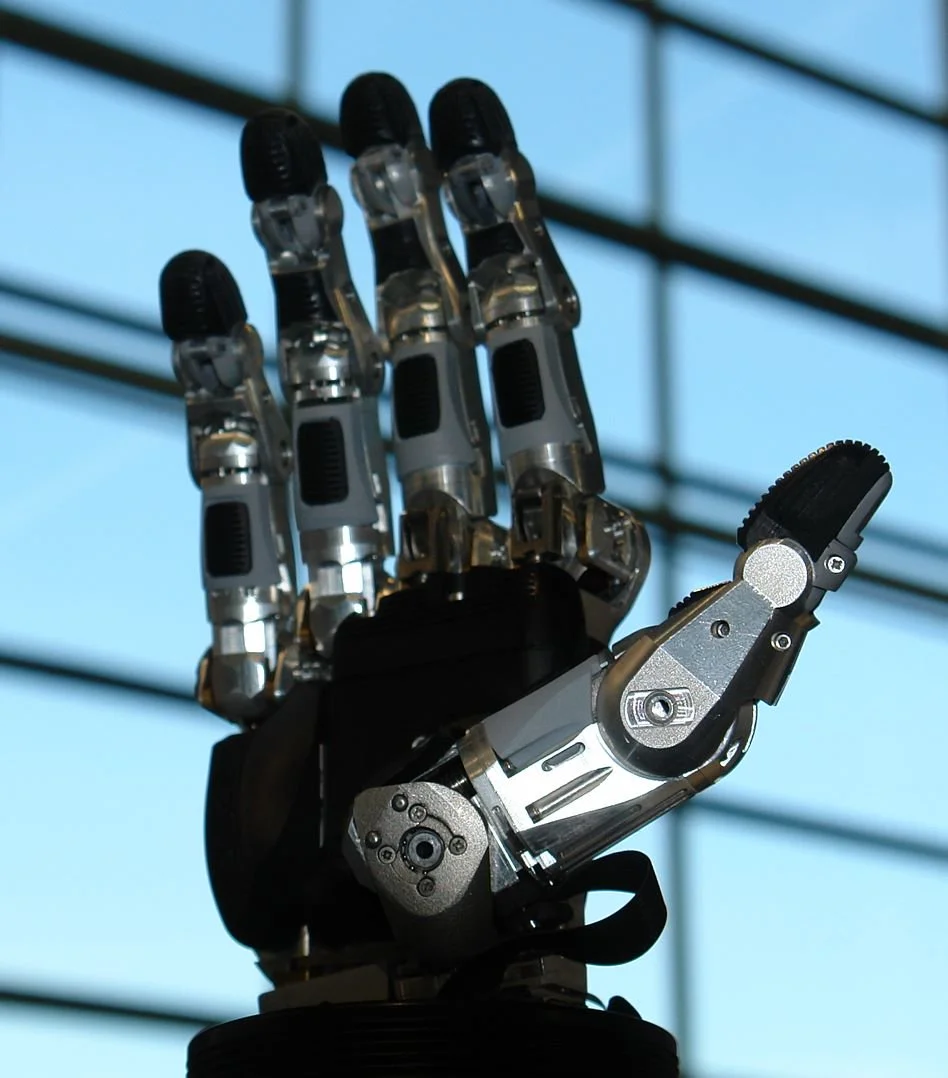
실제 로봇 실험에서는 확산 정책(diffusion policy), 비전·언어·행동(VLA) 모델 π0.5, 로비앤트의 LingBot-VLA 세 가지에 고정된 LingBot-Touch 특징을 더했다. 샤파 웨이브(Sharpa Wave)와 엑스핸드(XHand) 로봇 손으로 26개 과제를 과제당 20회씩 시험해 원래 모델, 원시 촉각 입력 추가, LingBot-Touch 추가를 비교했다.
시연에는 자물쇠에 열쇠 맞춰 넣기, 힘을 조절해 치약 짜기, 지퍼백 밀봉이 포함됐다. 시뮬레이션 강화학습 12개 과제에서는 촉각 없음, 촉각 CNN과 비교했다. 사전학습 데이터를 5,000시간 가까이 늘리는 동안 실제 로봇 성공률이 계속 올랐다고도 밝혔다. 다만 AI Newsway는 논문 PDF 전문을 열지 못해 과제별 성공률 수치는 확인하지 못했다.
앤트그룹의 로봇 AI 행보
로비앤트는 올해 1월 로봇용 '범용 두뇌'를 내세운 LingBot-VLA를 오픈소스로 공개했다. 해외 매체 AI 인사이더에 따르면 이 모델은 양팔 로봇 9개 구성에서 모은 2만 시간 이상의 실제 데이터로 사전학습했다. LingBot-Touch는 여기에 촉각을 더하는 셈이다.
전망
깃허브 저장소에는 추론용 고정 인코더만 있고 학습 코드는 없다. 가중치는 허깅페이스와 모델스코프에 올라 있으며, 내려받으려면 모델 저장소 접근 권한이 있는 계정이 필요하다고 안내돼 있다. 외부 연구진의 재현 결과는 아직 나오지 않았다.
자주 묻는 질문
카메라 이미지를 그대로 입력하나?
아니다. 모델 카드에 따르면 시각촉각식 센서는 RGB 원본 이미지가 아니라 변형·강도를 수치로 바꾼 값을 입력한다.
GPU 없이도 돌릴 수 있나?
저장소의 예제 명령은 CPU로 추론하도록 돼 있고, 엔비디아 GPU로 바꿔 쓰는 옵션도 있다.
참고 자료
- Learning Heterogeneous Tactile Representation for General Dexterous Manipulation — arXiv(2026년 11월 9일)
- LingBot-Touch Tactile Foundation Model — Robbyant(2026년 11월)
- Robbyant/lingbot-touch — GitHub(2026년 11월)
- Robbyant Open-Sources LingBot-VLA as a "Universal Brain" for Robots — AI Insider(2026년 1월 28일)

댓글 0
현재 댓글 작성이 비활성화되어 있습니다.