
ウィキメディア「AI学習はフェアユースの余地、RAGはライセンス順守を」
ウィキメディア財団は10月30日、オープンAIを巡る著作権訴訟にアミカスブリーフを提出したと公表した。AIの学習はフェアユースになり得るが、検索拡張生成(RAG)はCC BY-SA 4.0など元の著作物のライセンスを守るべきだと主張している。
ウィキペディアを運営するウィキメディア財団は、オープンAIを相手取った米国の著作権訴訟(併合審理)に意見書を提出し、AIモデルの学習とチャットボットによる検索利用を法的に区別するよう求めた。財団が10月30日(現地時間)に公表したアミカスブリーフ(法廷助言書)は、学習はフェアユースになり得る一方、質問に答えるためにコンテンツを取り込む検索拡張生成(RAG)は元の著作物のライセンスに従うべきだとしている。
要点
- ウィキメディアはオープンAIとニューヨーク・タイムズのどちらの側にも立たず、AIの利用方法ごとに個別に判断するよう求めた。
- 学習については、出来上がったモデルが元の著作物と「新しく異なるもの」であればフェアユースに当たり得るとした。
- RAGはウィキペディアのCC BY-SA 4.0などのライセンスを守り、執筆者のクレジットを表示すべきだとした。
ウィキメディアの意見書の主張
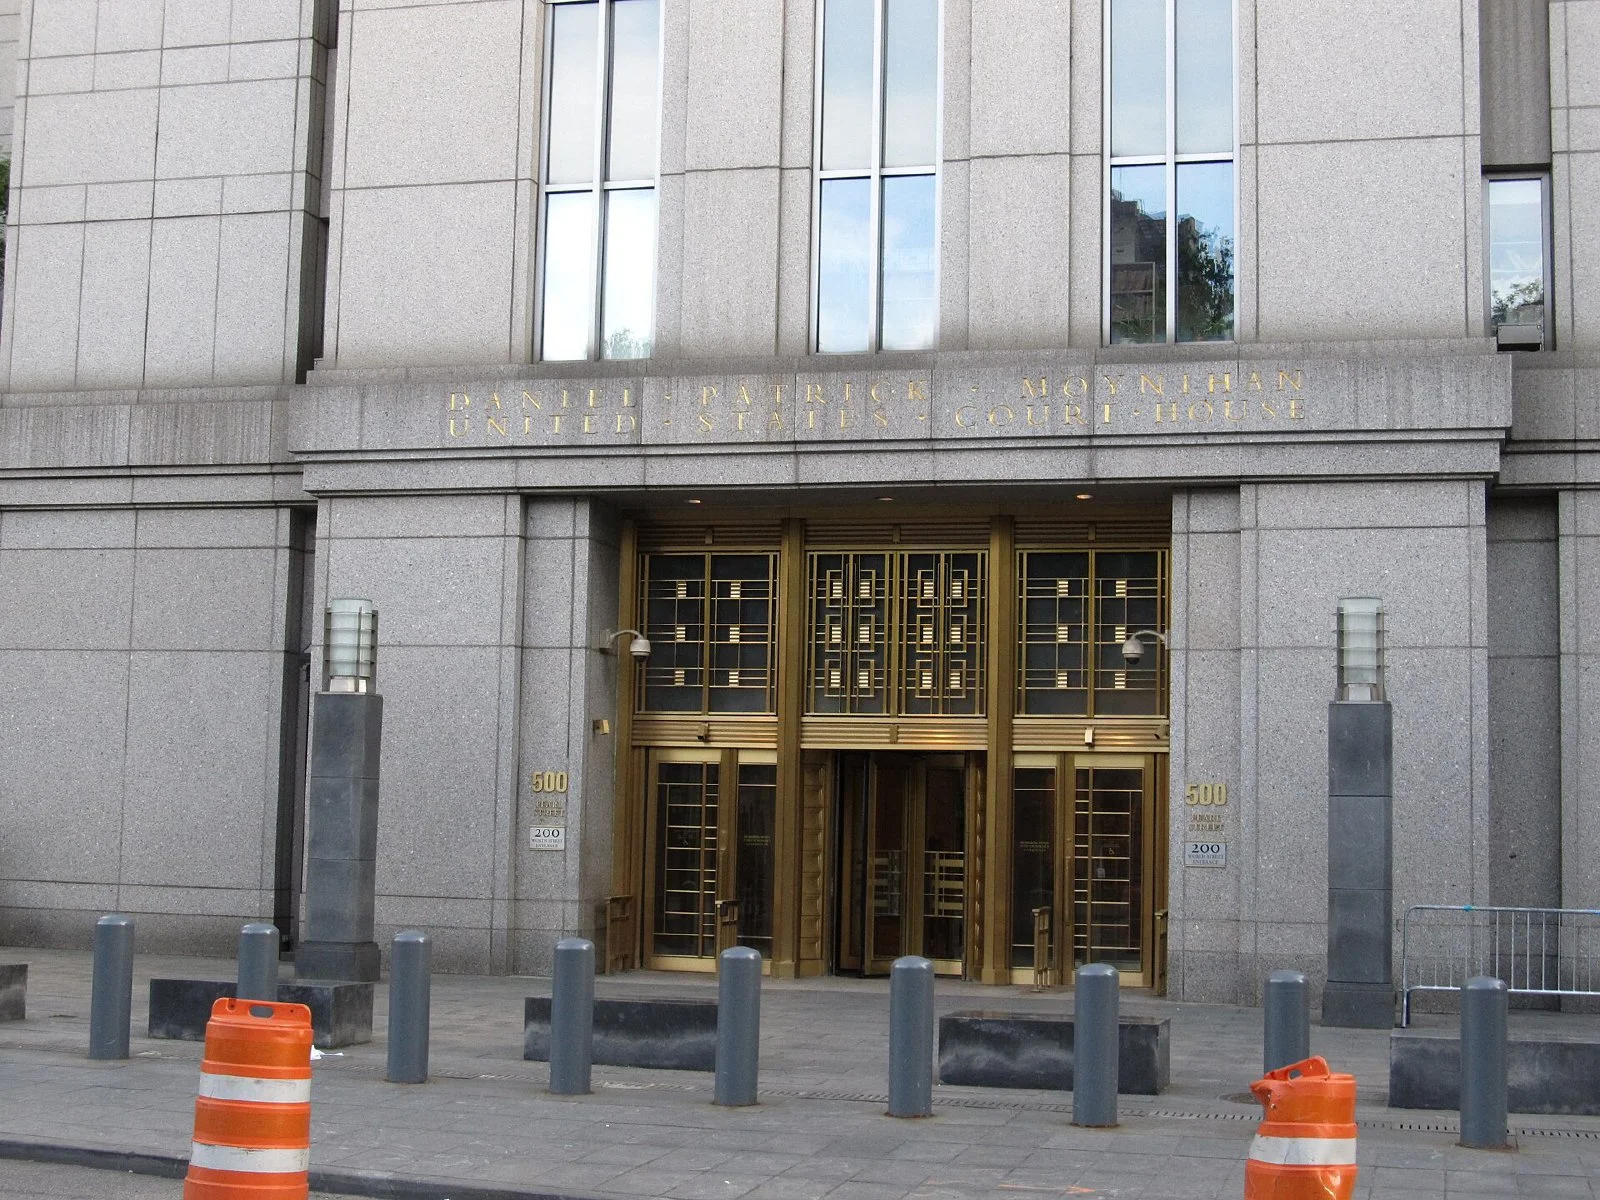
意見書はニューヨーク南部連邦地裁で審理中の「In re: OpenAI, Inc. Copyright Infringement Litigation」に提出された。12件の訴訟を併合したもので、最もよく知られているのはニューヨーク・タイムズが2023年にマイクロソフトとオープンAIを訴えた裁判である。
財団は公式ブログ「Diff」で「本件でオープンAIとニューヨーク・タイムズのどちらの側にも立たない」と表明した。どちらの方向であれ広すぎる結論にはリスクがあるとし、「裁判所はあらゆるAI利用を同一視するのではなく、素材がどのように使われているかを検討すべきだ」と主張した。
学習については「出来上がったモデルが元の著作物と新しく異なるものである場合、フェアユースに当たり得る」との立場である。学習を過度に制限する結論になれば、ウィキメディアのボランティアが必要な知識にアクセスすることも妨げられかねないと警告した。
AI学習とRAGを区別する理由
RAGは、利用者が質問した時点で外部の資料を取得し、回答の作成に使う仕組みだ。財団はこうした利用について、AI企業は「フェアユースとして扱うのではなく、元の著作物のライセンス要件を尊重すべきだ」としている。
ウィキペディアが採用するCC BY-SA 4.0は、原著作者のクレジット表示に加え、改変物も同じライセンスで公開することを求める。財団は「クレジットの表示は、人々が受け取る情報と、それを提供した執筆者とのつながりを保つ」と説明した。
収集の方法も問題にした。学習用に集める場合でも回答用に取得する場合でも、企業は「公開APIのレート制限を守るか、ウィキメディア・エンタープライズのAPIを利用しなければならない」という。大量収集がウィキペディアのサーバーに過大な負担をかけてはならないとの趣旨である。
背景:ウィキペディアが訴訟に関わる理由
財団によると、ウィキペディアには300言語で6700万本超の記事があり、約25万人のボランティア編集者が参加している。モデルの学習とチャットボットの回答の双方で頻繁に使われる情報源だ。
米テックメディアのザ・ネクスト・ウェブによると、バーナデット・ミーハン最高経営責任者(CEO)は「ウィキペディアが依拠する自由で開かれた人類の知識を守るため、本件で立場を表明する」と述べた。法務責任者のスティーブン・ラポルト氏はエンガジェットに対し、フェアユースの原則を慎重に適用しない判決は「自由な知識の持続可能性を脅かしかねない」と語った。
当事者の主張は大きく隔たっている。ニューヨーク・タイムズなどの報道機関は、著作物の取得、学習への利用、質問への回答での利用のいずれもフェアユースではないと主張する。一方、オープンAIは自社のあらゆる利用がフェアユースだとの立場だ。
今後の見通し
ザ・ネクスト・ウェブによると、シドニー・H・スタイン判事は意見書を受理するかどうかも、学習がフェアユースに当たるかどうかもまだ判断していない。エンガジェットは、略式判決が近く出る見通しだと伝えた。裁判所が学習と検索利用を分けて判断すれば、本件を超えてAI企業と報道機関・コンテンツ提供者とのライセンス交渉にも影響を与えそうだ。
よくある質問
ウィキメディアはオープンAIを支持したのか。
そうではない。一部の学習はフェアユースと見るが、検索に基づく回答はライセンスに従うべきだとしており、「すべての利用がフェアユース」とするオープンAIの主張とも異なる。
RAGとは何か。
検索拡張生成は、チャットボットが学習内容だけに頼らず、質問時に外部の資料を取得して回答に結び付ける技術である。
ウィキペディアのライセンスは何を求めているのか。
CC BY-SA 4.0は原著作者のクレジット表示と、改変物を同じライセンスで維持することを求めている。
参考資料
- Why Wikimedia is speaking up in a major AI copyright case — Wikimedia Diff(2026年10月30日)
- Wikimedia asks court to rule AI training fair use, but not chatbot copying — The Next Web(2026年10月30日)
- The Wikimedia Foundation weighs in on the NYT's case against OpenAI — Engadget(2026年10月30日)

コメント 0
現在コメントの投稿は無効になっています。