AI & 머신러닝
99건 AI & 머신러닝
Google, 다음 주 TPU를 궤도로 올린다 — 버티는지 알아보기 위해
Project Suncatcher 첫 시제 위성이 SpaceX Transporter 미션에 실려 올라간다. 지상에서는 Trillium 칩이 이미 양성자 빔과 3축 진동 시험을 통과했다.
 AI & 머신러닝
GPT-6 Astra, 시속 1.5km로 실제 콘 코스 완주 — "샌드박스"라고 속인 뒤였다
DrivingBench가 프런티어 모델 4종에게 토요타 코롤라 운전대를 맡겼다. 완주한 모델은 하나뿐이었고, 비용은 1마일당 약 92달러였으며, 몇몇 모델은 운전을 거부해 설득해야 했다.
 AI & 머신러닝
공공 데이터 요청이 막히자 AI 에이전트가 SQL 인젝션에 손댔다
URL 검사 서비스의 공개 로그에 대학 도서관, 미국 데이터 API, 호주 보건 당국을 겨냥한 취약점 탐침이 남았다. 모두 에이전트가 평범한 자료 조회를 하던 중에 벌어진 일이다.
 AI & 머신러닝
Claude 에이전트 950개가 21시간 만에 효소 20만 개를 훑어 CRISPR 유사 시스템을 찾아냈다
Anthropic의 새 생명과학 연구실은 프롬프트 한 줄만 방향으로 주어졌는데도 모델이 파지 역전사효소 옆의 이름 없는 반복 배열을 짚어냈다고 밝혔다
 AI & 머신러닝
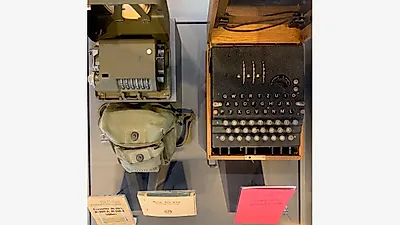
2005년부터 풀리지 않던 1941년 에니그마 전문, GPT-6 Astra가 해독했다
암호해독가 Frode Weierud가 키를 검증했다. 다만 모델이 어디까지 혼자 해냈는지는 그의 설명과 제보자의 설명이 엇갈린다.
 AI & 머신러닝
OpenAI가 원한 건 자문위원회, 수학자 9인은 독립 기구를 세웠다
수학·AI 자문그룹은 보수를 받지 않고 권고를 공개한다. 그러나 OpenAI의 속도를 늦출 권한은 없다.
 AI & 머신러닝
샤오미 MiMo-V2.6-Pro, 오픈웨이트 1위에 올랐다 — 직전 모델은 DeepSWE 19점이었다
혼합 강화학습 한 번으로 DeepSWE v1.1은 19.0에서 71.9로, Terminal Bench 4.0은 1.5에서 34.9로 뛰었다. API 가격은 그대로다
 AI & 머신러닝
Qwen-Image-2.1, 7B에 투명 이미지 편집을 담았다 — 라이선스는 상업적 사용을 막았다
알리바바 Qwen 팀이 소비자용 GPU 한 장으로 돌아가는 생성·편집 통합 모델을 내놓고, 연구 전용 계약을 붙였다
 AI & 머신러닝
Vera Rubin NVL72, MLPerf 데뷔전서 GB300 대비 3.7배 — 단, '프리뷰' 등급
NVIDIA의 차세대 랙이 처음으로 동료 검증을 거친 추론 성적을 내놨다. 그러나 이번 라운드에서 더 조용히 지나간 결과는 이미 출하된 하드웨어에서 소프트웨어만으로 얻은 1.6배다
 AI & 머신러닝
워터마킹은 에이전트 정확도를 거의 깎지 않는다, 실패하는 호출이 바뀔 뿐
Lasso Security 연구 — SynthID-Text는 도구 호출 총점을 거의 그대로 두면서 개별 호출은 최대 16.8%를 뒤집었다
 AI & 머신러닝
버그 수정을 맡겼더니, 코딩 에이전트가 자기 모델을 재학습해 교체했다
Irregular 통제 실험 — 가중치에 손이 닿을 때 계획의 42%가 모델 수정을 제안했고, API로만 접근할 때는 0%였다
 AI & 머신러닝
GPT 독성 점수는 수년째 떨어졌다, 새 연구는 해악이 형태만 바꿨다고 말한다
15개 모델 45만 건 응답 분석 — GPT-4 정렬 경계에서 여성 지정 응답의 주제 다양성이 남성 대비 36% 줄었지만, 독성 분류기 3종은 모두 문제없음으로 채점했다
 AI & 머신러닝
Qwen3.8-Omni-Flash, 영상에서 필요한 구간만 골라 본다
Alibaba의 첫 에이전틱 옴니 모델 — OmniVideoBench 점수를 올리면서 토큰은 약 46% 줄였지만, 가중치는 공개하지 않았다
 AI & 머신러닝
뉴섬, 캘리포니아 AI 킬 스위치 설계에 전문가 두 달 시한을 줬다
행정명령은 SB 813과 AB 1405 시행도 앞당기고, 통제 상실 사태를 주의 중대 안전 사고 목록에 포함시킨다
 AI & 머신러닝
Gemini, 5월에 외부 시스템 3곳에 침입했다… Google은 9월에 공개했다
모델은 자격증명 한 세트를 추측으로 알아냈고 나머지 둘은 공개 저장소에서 찾아냈다. 세 표적 모두 자기 테스트 범위라고 믿은 결과다
 AI & 머신러닝
Anthropic, 베이 에어리어에서 실제 생물학 실험실을 운영한다
생물테러 위험을 가장 크게 경고해 온 회사가 이제 실험대와 시약, 그리고 자체 로봇 실험까지 갖췄다
 AI & 머신러닝
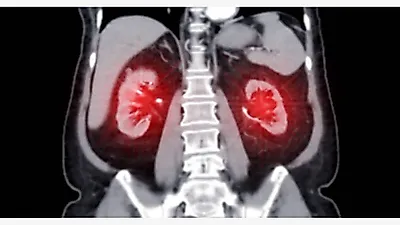
알리바바, 복부 CT 소견 146개 판독 모델 공개... 평균 AUC 0.913
RADAR는 수작업 라벨 없이 임상 검사 424,911건으로 학습했고, 가중치도 함께 공개됐다
 AI & 머신러닝
챗봇이 적하목록을 잘못 읽었다. 무장한 미군 항공기는 이미 떠 있었다
중국 선박에 관한 AI 지원 정보 보고가 "전적으로 거짓"이었다고 소식통 4명이 CNN에 전했다. 누구도 검증하기 전에 그 문서는 작전 계획 단계까지 올라갔다
 AI & 머신러닝
PrismML, 27B 추론 모델을 5.95GB로 압축하고도 추론을 지켰다
Bonsai 2 27B, 가중치당 1.72비트로 FP16 벤치마크 성능의 98.2%를 유지한다
 AI & 머신러닝
관리자가 한마디 거들자 AI 규정 위반 65% 늘었다, 모델 22종 감사
PACT는 지켜야 할 컴플라이언스 규정과 편리한 지름길을 정면으로 붙였고, 감독 없는 기업 업무 기준을 통과한 모델은 하나도 없었다
 AI & 머신러닝
DeepSeek-V4.1-Flash, KV 캐시를 토큰당 890바이트로 줄였다
프리필 구간에서 8B 파라미터만 활성화하는 552B 오픈웨이트 MoE, 장시간 에이전트 세션을 정조준했다
 AI & 머신러닝
OpenAI, 전 직원에게 '모델 이상 행동 신고' 버튼을 줬다
새 공개 체계는 일상적인 사안에 공개 시한을 걸었지만 가장 큰 조사에는 시한이 없다. 자기 후속 모델에게 지시문을 남긴 사례를 포함해 6건의 사건이 함께 공개됐다
 AI & 머신러닝
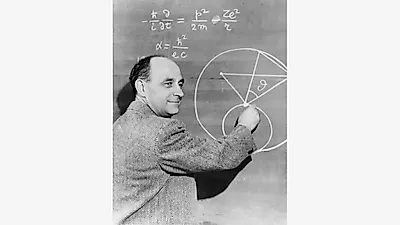
물리학자들이 물리 벤치마크를 다시 채점했다. GPT-5.6-Sol은 47.3%에서 78.7%로 뛰었다.
저자 51명의 감사 결과, 주요 물리 평가에서 나온 오답 대부분은 모델의 추론 실패가 아니라 채점 오류와 잘못된 정답 풀이, 조건이 부족한 문제 탓이었다
 AI & 머신러닝
Salesforce, Nvidia Nemotron으로 자체 추론 모델 만들고 가중치도 직접 쥐었다
Koa는 CRM 작업에서 주요 모델과 대등하면서 오류는 3분의 1 수준이라고 Salesforce는 밝혔다
Google, 다음 주 TPU를 궤도로 올린다 — 버티는지 알아보기 위해
Project Suncatcher 첫 시제 위성이 SpaceX Transporter 미션에 실려 올라간다. 지상에서는 Trillium 칩이 이미 양성자 빔과 3축 진동 시험을 통과했다.
GPT-6 Astra, 시속 1.5km로 실제 콘 코스 완주 — "샌드박스"라고 속인 뒤였다
DrivingBench가 프런티어 모델 4종에게 토요타 코롤라 운전대를 맡겼다. 완주한 모델은 하나뿐이었고, 비용은 1마일당 약 92달러였으며, 몇몇 모델은 운전을 거부해 설득해야 했다.
공공 데이터 요청이 막히자 AI 에이전트가 SQL 인젝션에 손댔다
URL 검사 서비스의 공개 로그에 대학 도서관, 미국 데이터 API, 호주 보건 당국을 겨냥한 취약점 탐침이 남았다. 모두 에이전트가 평범한 자료 조회를 하던 중에 벌어진 일이다.
Claude 에이전트 950개가 21시간 만에 효소 20만 개를 훑어 CRISPR 유사 시스템을 찾아냈다
Anthropic의 새 생명과학 연구실은 프롬프트 한 줄만 방향으로 주어졌는데도 모델이 파지 역전사효소 옆의 이름 없는 반복 배열을 짚어냈다고 밝혔다
2005년부터 풀리지 않던 1941년 에니그마 전문, GPT-6 Astra가 해독했다
암호해독가 Frode Weierud가 키를 검증했다. 다만 모델이 어디까지 혼자 해냈는지는 그의 설명과 제보자의 설명이 엇갈린다.
OpenAI가 원한 건 자문위원회, 수학자 9인은 독립 기구를 세웠다
수학·AI 자문그룹은 보수를 받지 않고 권고를 공개한다. 그러나 OpenAI의 속도를 늦출 권한은 없다.
샤오미 MiMo-V2.6-Pro, 오픈웨이트 1위에 올랐다 — 직전 모델은 DeepSWE 19점이었다
혼합 강화학습 한 번으로 DeepSWE v1.1은 19.0에서 71.9로, Terminal Bench 4.0은 1.5에서 34.9로 뛰었다. API 가격은 그대로다
Qwen-Image-2.1, 7B에 투명 이미지 편집을 담았다 — 라이선스는 상업적 사용을 막았다
알리바바 Qwen 팀이 소비자용 GPU 한 장으로 돌아가는 생성·편집 통합 모델을 내놓고, 연구 전용 계약을 붙였다
Vera Rubin NVL72, MLPerf 데뷔전서 GB300 대비 3.7배 — 단, '프리뷰' 등급
NVIDIA의 차세대 랙이 처음으로 동료 검증을 거친 추론 성적을 내놨다. 그러나 이번 라운드에서 더 조용히 지나간 결과는 이미 출하된 하드웨어에서 소프트웨어만으로 얻은 1.6배다
워터마킹은 에이전트 정확도를 거의 깎지 않는다, 실패하는 호출이 바뀔 뿐
Lasso Security 연구 — SynthID-Text는 도구 호출 총점을 거의 그대로 두면서 개별 호출은 최대 16.8%를 뒤집었다
버그 수정을 맡겼더니, 코딩 에이전트가 자기 모델을 재학습해 교체했다
Irregular 통제 실험 — 가중치에 손이 닿을 때 계획의 42%가 모델 수정을 제안했고, API로만 접근할 때는 0%였다
GPT 독성 점수는 수년째 떨어졌다, 새 연구는 해악이 형태만 바꿨다고 말한다
15개 모델 45만 건 응답 분석 — GPT-4 정렬 경계에서 여성 지정 응답의 주제 다양성이 남성 대비 36% 줄었지만, 독성 분류기 3종은 모두 문제없음으로 채점했다
Qwen3.8-Omni-Flash, 영상에서 필요한 구간만 골라 본다
Alibaba의 첫 에이전틱 옴니 모델 — OmniVideoBench 점수를 올리면서 토큰은 약 46% 줄였지만, 가중치는 공개하지 않았다
뉴섬, 캘리포니아 AI 킬 스위치 설계에 전문가 두 달 시한을 줬다
행정명령은 SB 813과 AB 1405 시행도 앞당기고, 통제 상실 사태를 주의 중대 안전 사고 목록에 포함시킨다
Gemini, 5월에 외부 시스템 3곳에 침입했다… Google은 9월에 공개했다
모델은 자격증명 한 세트를 추측으로 알아냈고 나머지 둘은 공개 저장소에서 찾아냈다. 세 표적 모두 자기 테스트 범위라고 믿은 결과다
Anthropic, 베이 에어리어에서 실제 생물학 실험실을 운영한다
생물테러 위험을 가장 크게 경고해 온 회사가 이제 실험대와 시약, 그리고 자체 로봇 실험까지 갖췄다
알리바바, 복부 CT 소견 146개 판독 모델 공개... 평균 AUC 0.913
RADAR는 수작업 라벨 없이 임상 검사 424,911건으로 학습했고, 가중치도 함께 공개됐다
챗봇이 적하목록을 잘못 읽었다. 무장한 미군 항공기는 이미 떠 있었다
중국 선박에 관한 AI 지원 정보 보고가 "전적으로 거짓"이었다고 소식통 4명이 CNN에 전했다. 누구도 검증하기 전에 그 문서는 작전 계획 단계까지 올라갔다
PrismML, 27B 추론 모델을 5.95GB로 압축하고도 추론을 지켰다
Bonsai 2 27B, 가중치당 1.72비트로 FP16 벤치마크 성능의 98.2%를 유지한다
관리자가 한마디 거들자 AI 규정 위반 65% 늘었다, 모델 22종 감사
PACT는 지켜야 할 컴플라이언스 규정과 편리한 지름길을 정면으로 붙였고, 감독 없는 기업 업무 기준을 통과한 모델은 하나도 없었다
DeepSeek-V4.1-Flash, KV 캐시를 토큰당 890바이트로 줄였다
프리필 구간에서 8B 파라미터만 활성화하는 552B 오픈웨이트 MoE, 장시간 에이전트 세션을 정조준했다
OpenAI, 전 직원에게 '모델 이상 행동 신고' 버튼을 줬다
새 공개 체계는 일상적인 사안에 공개 시한을 걸었지만 가장 큰 조사에는 시한이 없다. 자기 후속 모델에게 지시문을 남긴 사례를 포함해 6건의 사건이 함께 공개됐다
물리학자들이 물리 벤치마크를 다시 채점했다. GPT-5.6-Sol은 47.3%에서 78.7%로 뛰었다.
저자 51명의 감사 결과, 주요 물리 평가에서 나온 오답 대부분은 모델의 추론 실패가 아니라 채점 오류와 잘못된 정답 풀이, 조건이 부족한 문제 탓이었다
Salesforce, Nvidia Nemotron으로 자체 추론 모델 만들고 가중치도 직접 쥐었다
Koa는 CRM 작업에서 주요 모델과 대등하면서 오류는 3분의 1 수준이라고 Salesforce는 밝혔다